22580:从 GPT-2 到 KimiK3,一文讲清
ali (@waterloo_intern)
2026-07-27
D
原文
---
title: "22580:从 GPT-2 到 KimiK3,一文讲清"
author: "ali (@waterloo_intern)"
source_url: "https://x.com/waterloo_intern/status/2081762065392541951"
published_at: "2026-07-27T15:22:08.000Z"
fetched_at: "2026-07-28T14:46:19Z"
updated_at: "2026-07-28T14:53:20Z"
language: "zh"
review_status: "draft"
---
# 22580:从 GPT-2 到 KimiK3,一文讲清

二万二千五百八十。也就是说,一个 KimiK3(2026)里面装得下 22580 个 GPT-2(2019)模型。七年里,我们把规模放大了 22580 倍。但这真的只是……规模吗?
在这篇 worklog 里,我会讲清楚我们是怎么走到这里的,以及从那时到现在,实际变化到底有多少、又有多少并没有变。我们会一路追踪通向 KimiK3 的主要架构演进。

# GPT-2
GPT-2 是一个仅解码器(decoder-only)架构:
```python
tok_emb = self.transformer.wte(idx) # token embeddings of shape (b, t, n_embd)
pos_emb = self.transformer.wpe(pos) # position embeddings of shape (t, n_embd)
x = self.transformer.drop(tok_emb + pos_emb)
for block in self.transformer.h:
x = block(x)
x = self.transformer.ln_f(x)
logits = self.lm_head(x)
return logits
```
输入会先得到 token embedding 和位置 embedding:

把每个 transformer block 放大来看,结构是这样的:
```python
class Block(nn.Module):
def __init__(self, config):
super().__init__()
self.ln_1 = LayerNorm(config.n_embd, bias=config.bias)
self.attn = CausalSelfAttention(config)
self.ln_2 = LayerNorm(config.n_embd, bias=config.bias)
self.mlp = MLP(config)
def forward(self, x):
x = x + self.attn(self.ln_1(x))
x = x + self.mlp(self.ln_2(x))
return x
```
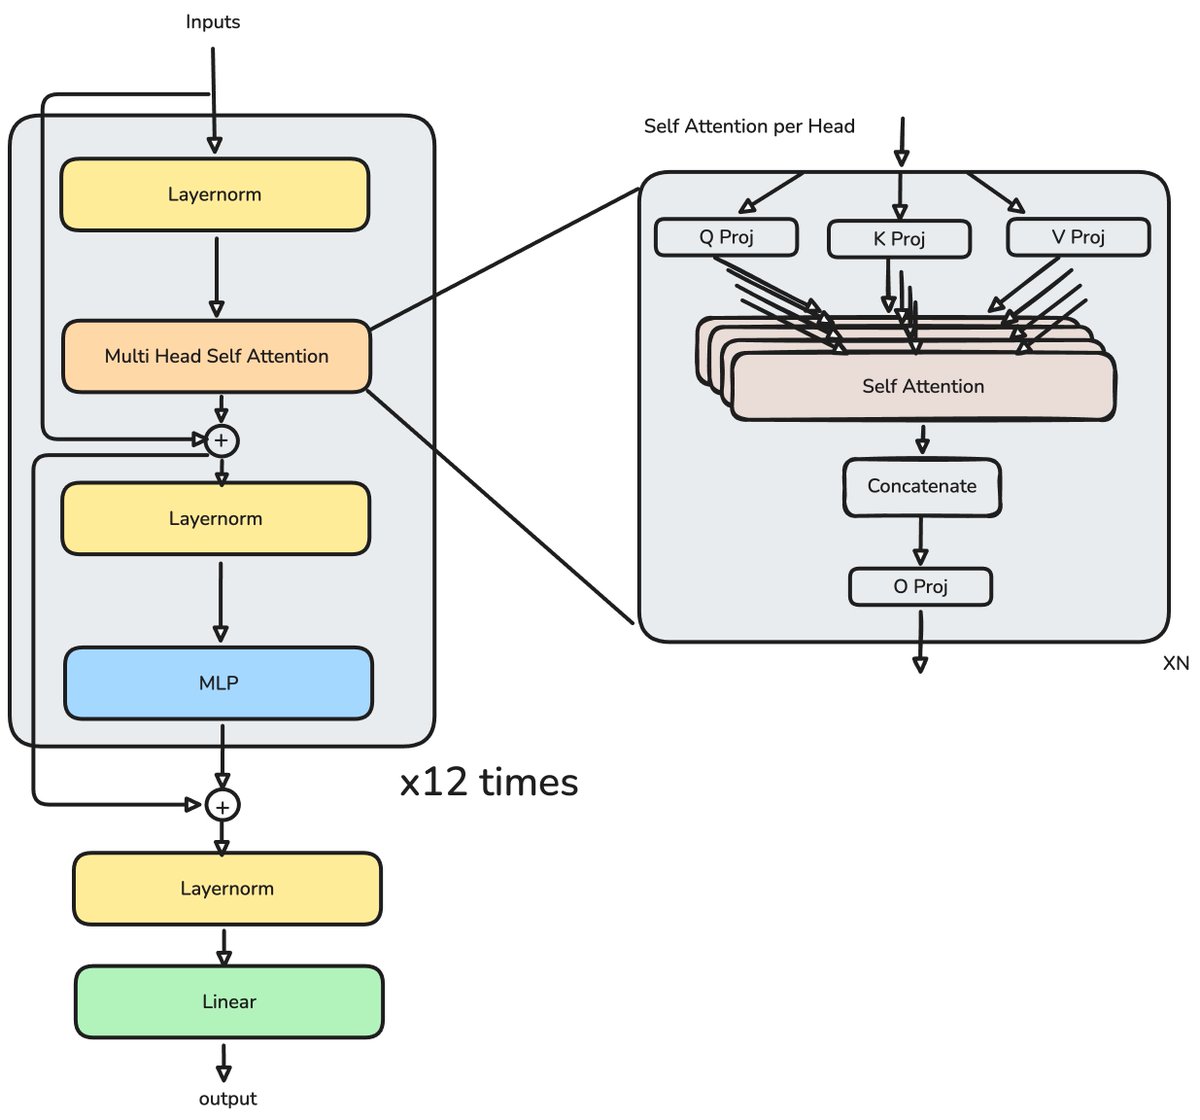
注意力过程如下:
```python
B, T, C = x.size() # batch size, sequence length, embedding dimensionality (n_embd)
# calculate query, key, values for all heads in batch and move head forward to be the batch dim
q, k, v = self.c_attn(x).split(self.n_embd, dim=2)
k = k.view(B, T, self.n_head, C // self.n_head).transpose(1, 2) # (B, nh, T, hs)
q = q.view(B, T, self.n_head, C // self.n_head).transpose(1, 2) # (B, nh, T, hs)
v = v.view(B, T, self.n_head, C // self.n_head).transpose(1, 2) # (B, nh, T, hs)
# manual implementation of attention
att = (q @ k.transpose(-2, -1)) * (1.0 / math.sqrt(k.size(-1)))
att = att.masked_fill(self.bias[:,:,:T,:T] == 0, float('-inf'))
att = F.softmax(att, dim=-1)
att = self.attn_dropout(att)
y = att @ v # (B, nh, T, T) x (B, nh, T, hs) -> (B, nh, T, hs)
y = y.transpose(1, 2).contiguous().view(B, T, C) # re-assemble all head outputs side by side
# output projection
y = self.resid_dropout(self.c_proj(y))
return y
```
一旦生成最终的隐藏状态(hidden-state)矩阵,语言模型头(language-model head)就会把它映射成词表 logits。在自回归解码时,只需要最后一个位置的 logits 来选择下一个 token。
> *这就是 decoder-only 生成中的一个低效点:模型会为每个输入位置计算表示,但每一步解码只消费最后一个位置的 logits。如果没有缓存,下一 token 时很多工作都会被重复计算。*
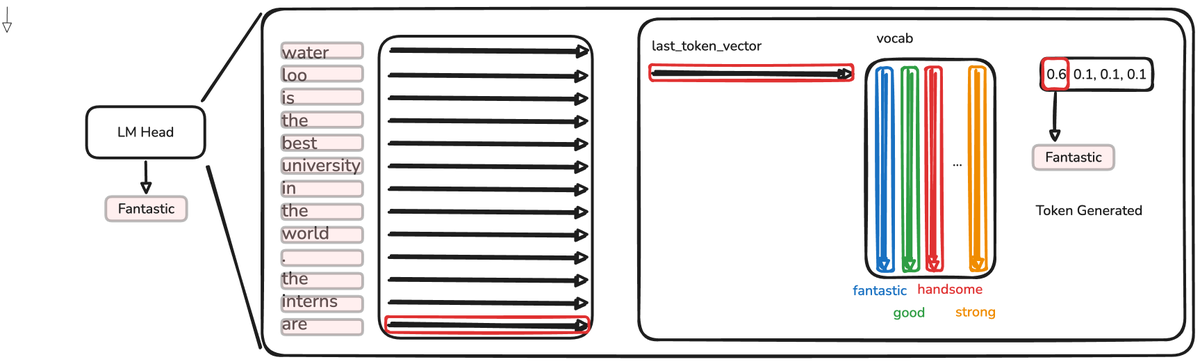
KV cache 来自一个很直接的观察:把生成出来的 token 追加到输入之后,如果不做缓存,模型就会重新计算所有之前 token 的投影。把它们的 key 向量和值向量存下来,就能避免这部分重复工作。
这个存储就是 KV cache。它会保留前 N-1 个 token 的向量,并且可能大到造成 memory bandwidth 瓶颈。
总的来说,在大约 5 万个可能 token、12 个 block、12 个 head,以及 768 的 embedding 维度下,我们的基线模型大约有 124M 参数。
```python
vocab_size: int = 50304 # GPT-2 vocab_size of 50257, padded up to nearest multiple of 64 for efficiency
n_layer: int = 12
n_head: int = 12
n_embd: int = 768
```
一个 2.8 万亿参数的 KimiK3 模型,参数量大约相当于 22580 个 GPT-2 模型。
# Linear Attention
Softmax attention 会在 q·k 乘积之后施加非线性,这会把每个 query 和每个 key 耦合在一起。Linear attention 则会把一个特征映射(feature map,比如 ELU+1)分别作用在 q 和 k 上。这样乘积就可以重新结合,于是不断增长的 K 和 V 向量集合可以被折叠进一个固定的 D×D 状态里。
论文里的 O(N²) 表述一开始让我有点困惑。所谓“transformer 每个时间步的成本会随当前序列长度的平方增长”并不准确。那是 FlashAttention 解决的问题……然后我看到这篇论文是 2020 年发布的。
在当时,训练通常会显式物化完整的 N×N 注意力矩阵,FlashAttention 还不存在,参考自回归实现也经常在没有 KV cache 的情况下重新计算 token 历史。
```python
def forward(self, x, mask=None, past_kv=None):
# x is b,t,d
b,t,d=x.shape
d_head=d//self.num_heads
h=self.num_heads
qkv=self.qkv_proj(x)
q=qkv[:, :, :d].view(b,t,h,d_head).transpose(1,2)
k=qkv[:, :, d:2*d].view(b,t,h,d_head).transpose(1,2)
v=qkv[:, :, 2*d:].view(b,t,h,d_head).transpose(1,2)
# at prefill, q,k,v have shapes b,h,t,d
# at decode, shape is b, h, 1, d
# so i cat at the t dimension, dim(2)
if past_kv is not None:
k_past=past_kv[0]
v_past=past_kv[1]
k=torch.cat((k_past, k), dim=2)
v=torch.cat((v_past, v), dim=2)
scores=(q@k.transpose(-1,-2))/math.sqrt(d_head)
if past_kv is None: #we're in prefill and need to mask
causal_mask=torch.ones(t,t,dtype=bool, device=q.device)
causal_mask=torch.triu(causal_mask, diagonal=1)
scores=scores.masked_fill(causal_mask, float('-inf'))
if mask is not None:
scores=scores.masked_fill(~mask, float('-inf'))
#get attn (bhtt x bhtd)
attn=scores.softmax(-1)#bhtt
o=attn@v #bhtd
o=o.transpose(1,2).contiguous().view(b,t,d) #b,t,d
# use x to get qkv
o_proj=self.o_proj(o)
past_kv=(k, v)
return o_proj, past_kv
```
同一个过程用图会更容易看清。每一步 decode 都会对 HBM 做两次 ND 读取和两次 1D 写入,而 KV cache 会随着序列长度以 O(N) 线性增长。
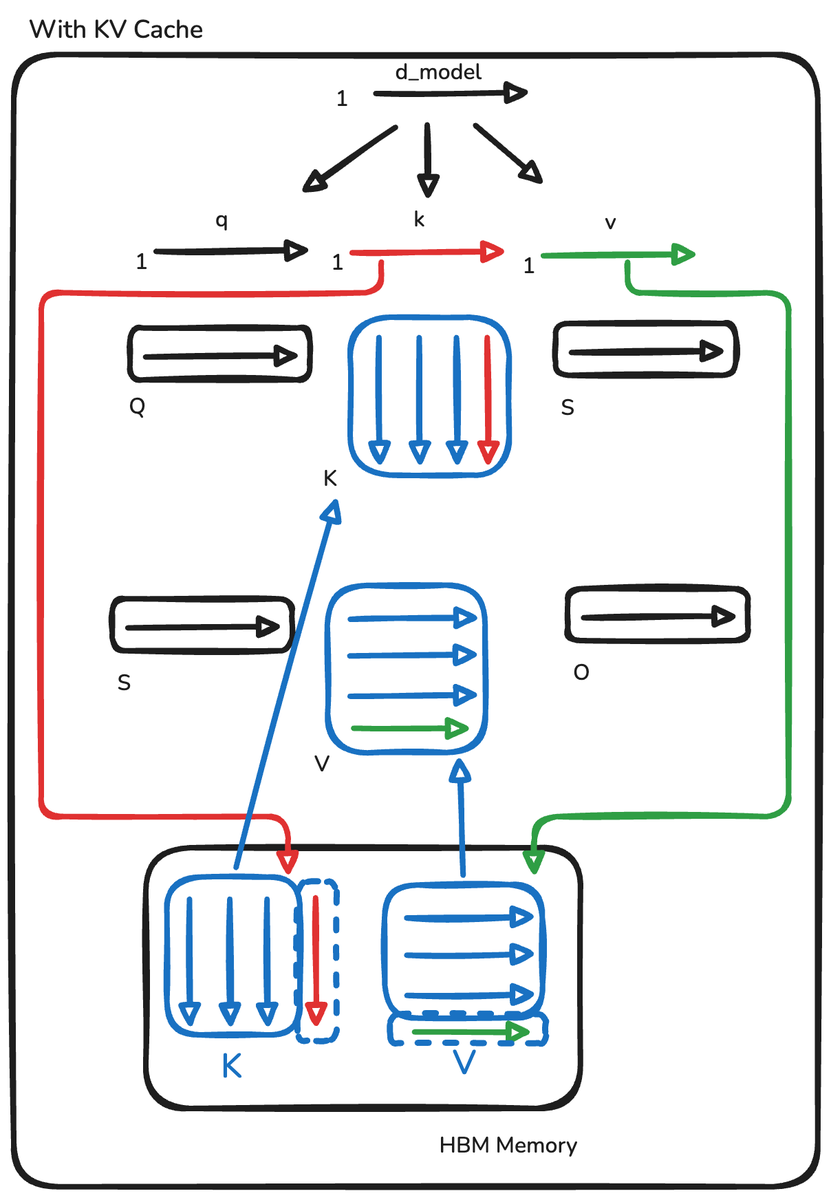
注意这里有大量读写,而这篇论文把它替换成了:
```python
def forward(self, x, mask=None, cache=None):
# x is b,t,d
b,t,d=x.shape
d_head=d//self.num_heads
h=self.num_heads
qkv=self.qkv_proj(x)
q=qkv[:, :, :d].view(b,t,h,d_head).transpose(1,2)
k=qkv[:, :, d:2*d].view(b,t,h,d_head).transpose(1,2)
v=qkv[:, :, 2*d:].view(b,t,h,d_head).transpose(1,2)
k=F.elu(k)+1
k=k.transpose(-1,-2)
q=F.elu(q)+1
S,z=cache if cache is not None else (0.0, 0.0)
S=S+k@v
z=z+k
o=q@S #bhtd
denom=q@z
o_scaled=o/denom
o_scaled=o_scaled.transpose(1,2).contiguous().view(b,t,d)
o_proj=self.o_proj(o_scaled)
cache=(S,z)
return o_proj, cache
```
这里有一个权衡。
在这里,我们把 softmax 使用的指数函数,换成了在 q 和 k 交互之前分别作用到二者上的 ELU+1。两种方法都会对得到的分数做归一化,但 linear attention 使用的特征映射,是对 softmax kernel 表达能力更弱的一种近似。这个近似可能降低保真度,不过实际准确率损失取决于架构和工作负载。
注意,我们仍然会除以 qk 的和,只是图里为了简洁省略了这一点。从高层看,attention 包含三个步骤:
1. 让 qk 分数变为非负。Linear attention 使用 ELU+1,而 softmax 使用指数化。
2. 除以总和。
3. 计算 value 的加权平均。
这保留了 attention 的基本契约,但用表达能力较弱的特征映射来让 QK 分数非负。
# DeltaNet(Fast Weight Programmers)
有限缓存必须覆盖或合并已经存进去的信息。来自 token i-1 的状态不会拥有自己的独立槽位;它会被加到同一个 D×D 矩阵里。因此,新的 query 再也不能完美取回每个更早 token 的孤立表示。
这种加法同时也是效率提升的来源。以加法更新 cache,而不是用拼接更新,可以避免它以 O(N) 增长;但同一个操作也会导致信息互相干扰。DeltaNet 要解决的正是这种可恢复性损失。
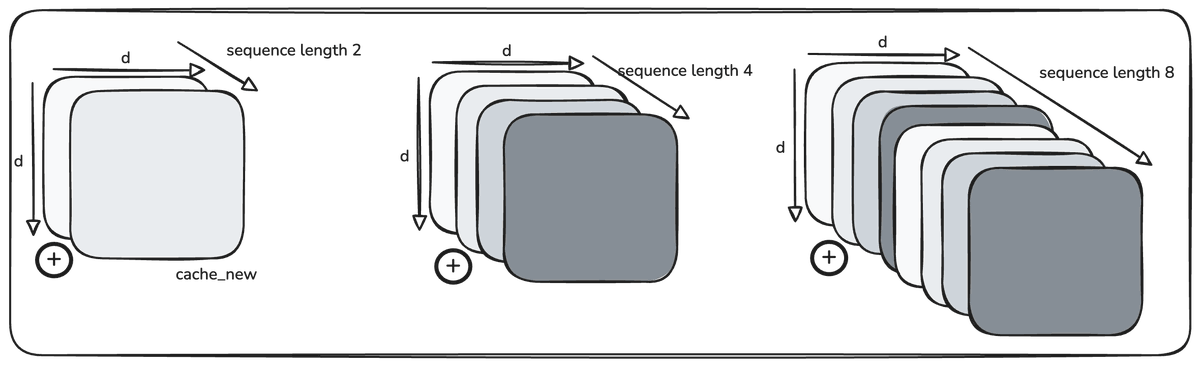
Schlag 的论文(Fast Weight Programmers)对此说得很清楚:“当序列长度超过存储容量时,模型可能最终进入超容量状态。要在这种状态下正常工作,模型应该学会与记忆内容动态交互,并有选择地决定保留哪些 key-value association、删除哪些。纯加法指令可能不适合这个目的……像式 17 那样不断把新的 association 加进有限大小的记忆,最终不可避免会到达极限。”
让 linear attention 变得有吸引力的状态,也就是 N 远大于 D 的状态,同时也暴露出它的主要限制。一旦状态超过有效容量,association 就会开始互相干扰,因为更新是加法式的,而且没有任何东西会离开缓存。
```python
def forward(self, x, mask=None, cache=None):
# x is b,t,d
b,t,d=x.shape
d_head=d//self.num_heads
h=self.num_heads
qkv=self.qkv_proj(x)
q=qkv[:, :, :d].view(b,t,h,d_head).transpose(1,2)
k=qkv[:, :, d:2*d].view(b,t,h,d_head).transpose(1,2)
v=qkv[:, :, 2*d:].view(b,t,h,d_head).transpose(1,2)
q = F.normalize(F.silu(q), dim=-1)
k = F.normalize(F.silu(k), dim=-1)
beta = torch.sigmoid(self.w_beta(x)).view(b, 1, t, 1)
# new: per-token write strength
S = cache if cache is not None else 0.0
v_old = k @ S # read the board at this key
u = beta * (v - v_old) # the delta: only what's actually new
S = S + k.transpose(-1, -2) @ u # same outer-product write as before
o = q @ S # read, no denominator
o = o.transpose(1, 2).contiguous().view(b, t, d)
return self.o_proj(o), S
```
一个可视化例子会让它更容易跟上。

取一个写成 S = k.T @ v 的单个 association。如果用同一个 key 读回,就会得到 k @ (k.T @ v),也就是 (k @ k.T) v,即 k 的平方范数乘以 v。因此,读取结果会按 key 的平方范数缩放;如果把 k 归一化成单位长度,或者直接用范数除掉结果,就能精确取回 v。
Q 也是一个学出来的指针。Wq 和 Wk 读取同一条 residual stream,而一个事实对应的 query 会指向这个事实写入时使用的 key 方向。更新时会先询问当前 key 能从 cache 中取回什么信息。它会从我们想要存储的 value 中减去这部分已有信息,把 key 乘上这个差值,再把结果加回去。旧信息被移除,新信息被写到原来的位置。
# DeltaNet(Parallelizing Linear Transformers with Delta Rule)
这是本文最难的一节。我花了大约七个小时才形成一个可工作的理解,所以我会从实现出发来讲。简而言之,DeltaNet 实现了一个带有广义 Householder transition matrices 的一阶线性递推,从而支持按 chunk 并行的 forward pass,实现硬件高效的线性时间训练。它把输入和输出切成若干个大小为 C 的 chunk,并基于前一个 chunk 的最终状态,以及当前 chunk 的 query、key、value block 来计算每个 chunk 的输出。
实际问题在于预填充(prefill)。对一段 T 个 token 的序列,Delta rule 的直接实现会长这样:
```python
S = torch.zeros(b, h, dh, dh) if cache is None else cache
outs = []
for i in range(t):
k_i = k[:, :, i:i+1]
v_i = v[:, :, i:i+1]
b_i = beta[:, :, i:i+1]
v_old = k_i @ S
u_i = b_i * (v_i - v_old)
S = S + k_i.transpose(-1, -2) @ u_i # write
outs.append(q[:, :, i:i+1] @ S)
o = torch.cat(outs, dim=2)
```
不同于标准 attention,这个形式要求在每个 key vector 上做一次修正(correction),所以通向并行矩阵乘法的路径并不显然。即使没有 Delta rule,直接的 linear-attention prefill 也仍然是顺序的:
```python
S = torch.zeros(b, h, dh, dh) if cache is None else cache
outs = []
for i in range(t):
q = q[:, :, i:i+1]
k = k[:, :, i:i+1]
v = v[:, :, i:i+1]
S=S_old+k@v
o=q@S #bhtd
o=self.norm(o)
o=o.transpose(1, 2).contiguous().view(b, t, d)
out=self.o_proj(o)
cache=S
outs.append(out)
o = torch.cat(outs, dim=2)
```
分块形式(chunked formulation)提供了更高效的做法。通过一个例子会更容易理解其中机制:

令 C=N 会退化回标准 O(N²) attention,而 C=1 则得到常规 linear attention。中间取值是在二者之间插值:用更多 chunk 内工作换取更好的硬件利用率。实践中,C 经常取 64 或 128,因为 tensor-core 指令在这个粒度上运行高效;UMMA 就是一个例子。
中间 tile 会作为状态更新的一部分被折叠进 S:

```python
S = torch.zeros(b, h, dh, dh) if cache is None else cache
outs = []
for i in range(t//C):
q_c = q[:, :, i*C:(i+1)*C]
k_c = k[:, :, i*C:(i+1)*C]
v_c = v[:, :, i*C:(i+1)*C]
o_prev=q_c@S #this is everything up to this block
attn=(q_c@k_c.transpose(-1,-2)).tril() #masked attention
o_curr=attn@v_c
o=o_prev+o_curr
S_new=k_c.transpose(-1,-2)@v_c #recurrent attention
S=S+S_new
outs.append(o)
o = torch.cat(outs, dim=2)
```
在一个 block 内,我们做的是 q(kᵀv)。这是先算 score,也就是带 mask 的正常 attention 顺序。跨 block 时,我们遵循 (kᵀv)q,也就是 recurrent 顺序,先处理 state。Attention 会以 O(N²) 增长,而这种做法不会。在一个 block 内,我做真正的 attention(带 mask 的 QKᵀ 乘以 V);跨 block 时,我把所有东西折叠进 state,再用一次 matmul 读回来。所以成本被拆成两部分。有一个固定项 2Ld²,这是 state 相关工作,完全不关心 C。还有一个增长项 2LCd,也就是位于对角线上的 score matrices。Full attention 只是 C 等于 L 的情况,此时第二项变成 2L²d,也就是二次复杂度。所以 C 越小,FLOPs 越少。
从纯 FLOP 角度看,C=1 是最便宜的选项,但 wall-clock time 不一定最短。当工作能高效映射到 GPU 的矩阵乘硬件上时,GPU 可以更快完成更多算术。
下一步,是把同样的方法扩展到 DeltaNet。

底层问题很简单:用于纯加法 attention 的 chunking 方法,并不能直接应用到 delta updates 上:
```python
v_old = k_i @ S
u_i = b_i * (v_i - v_old)
```
我们需要每一个单独的状态,才能算出需要被减掉的信息。如果不做某种数学上的重参数化,就没法用同样的方式并行化。因此,作者把 delta updates 从下面这个形式改写:
```python
u=v_new-v_old
S_t= S_(t-1)+K.T@u
o=q@S_T
```
在这里,一个顺序循环每次迭代计算一个 delta。重参数化之后的形式是:
```python
S_t = S_{t-1}(I − β_t k_t k_tᵀ) + β_t v_t k_tᵀ
o_t = S_t q_t
```
这个形式允许 chunked code 一次性计算所有 C 个 delta:
```python
def chunk_delta_rule_forward(Q, K, V, beta, C):
# L: sequence length, d: head dimension
L, d = Q.shape
# chunking
Q, K, V = map(lambda x: x.reshape(-1,C,d), [Q, K, V])
beta = beta.reshape(-1, C)
K_beta = K * beta.unsqueeze(-1)
V_beta = V * beta.unsqueeze(-1)
# compute eq. 10 with vectorized forward substitution for fast inverse
T = -(K_beta @ K.t()).tril(-1)
for i in range(1, C):
T[i, :i] = T[i, :i] + (T[i, :, None] * T[:, :i]).sum(-2)
T += torch.eye(C)
W = T @ K_beta
U = T @ V_beta
# chunkwise parallel. Eq. 8-9
S = torch.zeros(d, d)
O = torch.empty_like(V)
for i in range(L//C):
q_i, k_i, w_i = Q[i], K[i], W[i]
u_i = U[i] - w_i @ S # the corrections, all of one chunk
o_inter = q_i @ S
A_i = (q_i @ k_i.t()).tril() #qk.t
o_intra = A_i @ u_i # attention @ v (with corrections, so u)
S += k_i.t() @ u_i # update state with addition
O[i] = o_intra + o_inter #update output with flash + recurrent
return O.reshape(L, d)
```
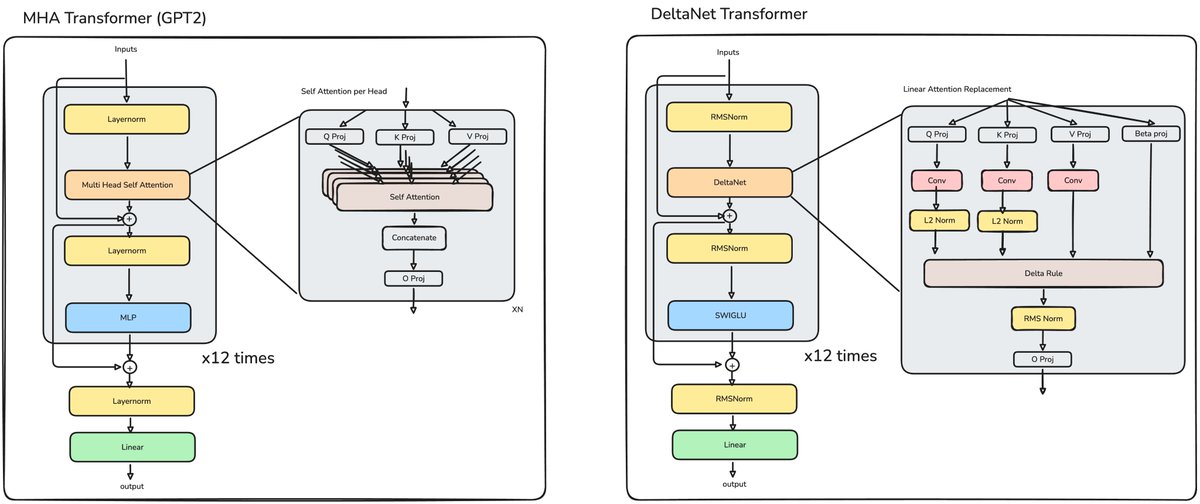
这把我们带到第一个对比点:MHA vs DeltaNet Transformers:
# Gated Delta Net
现在,我们已经有了一种能对 cache 做精确修改的方法。对于每一个新事实(每一个新的 key vector),我们都可以准确查看那个位置上存着什么旧信息,并用我们想要关注的新信息替换它。
不过,这个机制只能忘掉那些有特定替代项的 association。它无法在上下文切换(context switch)时高效清除多个 association,也无法对记忆做一般性的衰减来释放容量。
如果我们做的是纯加法 linear attention:
加入遗忘能力会很简单。我们只需要一个控制遗忘状态的参数:
```python
S_old=cache
S_new=k@v
# cache=S_old+S_new
cache=alpha * S_old + S_new
```
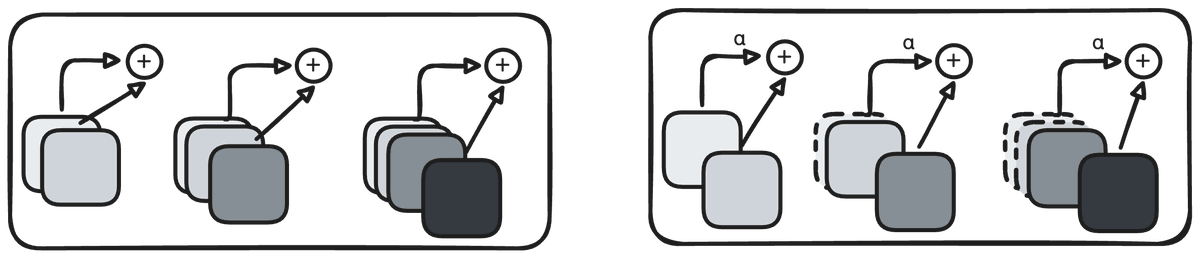
这就是 Mamba-2 的贡献。我们先让之前的 cache 衰减,再以完整强度加入新的 cache,从而防止 state 无边界增长。
在每个时间步用一个动态比例统一衰减所有 key-value association,是一个可行的方法,Mamba 做的就是这个。但它没有考虑不同 key-value association 重要性不同。
也就是说,如果模型需要忘掉某一个特定 association,所有 association 都会被同等程度地遗忘。相比之下,Delta rule 可以更新单个事实,但没有办法让其他事实衰减。
所以 Gated Delta rule 把 Mamba 的 gated update rule 和 Delta rule 结合起来。它加入一个参数 alpha:当 alpha 设为 1 时切换到纯 Delta rule,当 alpha 设为 0 时清空记忆。挑战在于如何用同样的并行 chunk 方法实现这一点。
实现使用了上一节描述的同一个 DeltaNet 重参数化。数学上几乎完全相同,只多了一个取值在 0 到 1 之间、由数据决定的标量,用来控制先前 state 的衰减。这把有效的 key-value association 学习和自适应记忆管理结合了起来。
对应的代码改动如下:
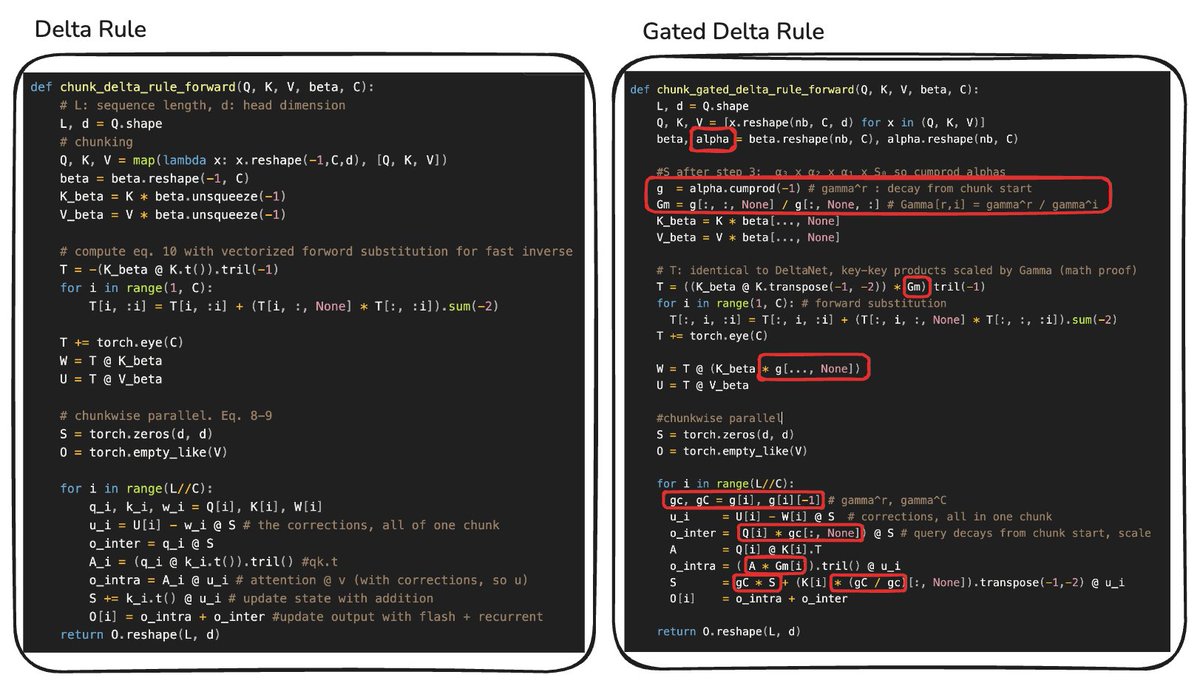
γʳ/γⁱ 这一项负责累计衰减。一个在 time step x 写入、在 x+t 读取的 token,已经被乘上了 αₓαₓ₊₁αₓ₊₂…αₓ₊ₜ。这相当于 prefix-sum 计算的乘法版本。
由此得到的架构看起来是这样的:

# KDA/Kimi Linear
到这里,研究者开始尝试混合模型:在一个架构里结合多种 attention 形式,比如把 Gated DeltaNet 和 Mamba 结合起来。
Kimi Linear 引发关注,核心在于一个主张:在受控比较下,它优于 full attention。作者把它呈现为一种即插即用的架构替代方案,质量更好,解码吞吐量最高可提升 6 倍。
Kimi Linear 对 Gated DeltaNet 的改进,是引入了细粒度 gating。它不再使用单个标量衰减,而是为每个通道(channel)学习一个单独的衰减值。

KDA update rule 仍然类似,但代码现在更像这样:

这里,alpha.reshape(nb, C, d) 捕捉到了论文最重要的贡献:对 memory decay 做细粒度控制。
和 DeltaNet Transformer 放在一起看,Kimi Linear 架构引入了三项主要变化:
1. 它使用混合系统,交错插入 Multi-head Latent Attention(MLA)层。
2. 它用 Mixture-of-Experts(MoE)层替换 MLP。
3. 它通过 alpha projection 为 DeltaNet 增加容量。
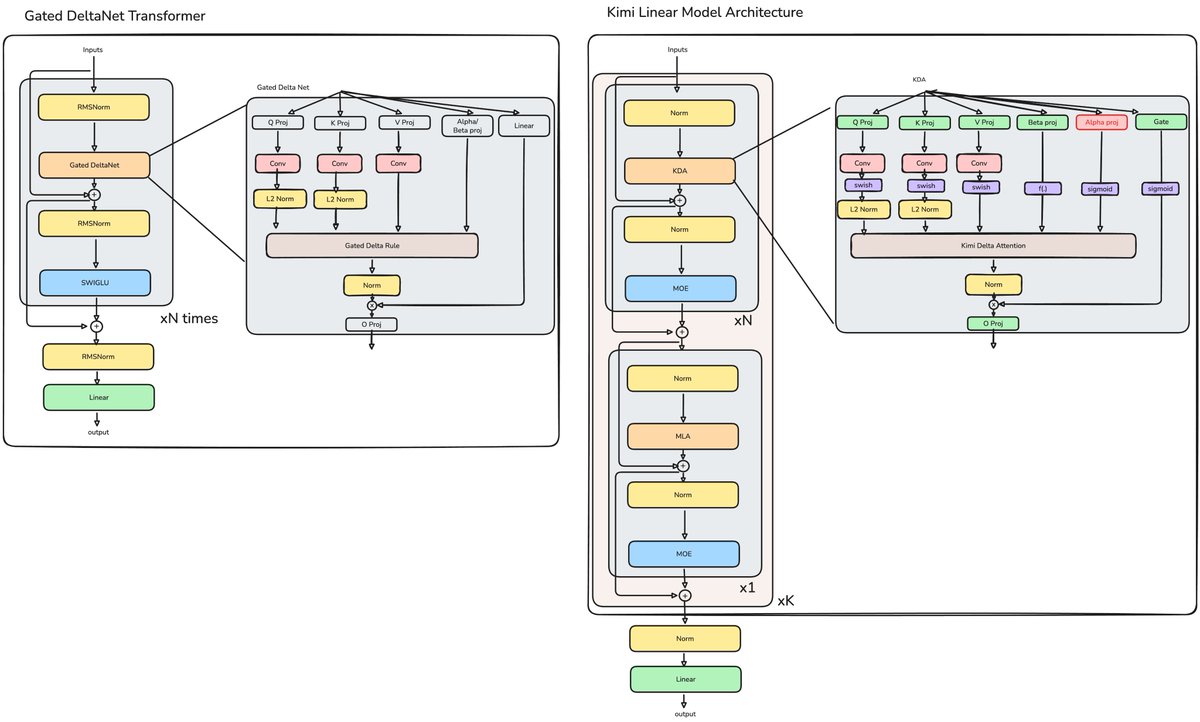
后面的章节会更详细地介绍 MLA 和 MoE。现在重要的是:这不是盲目扩大规模。新增的容量有明确的数学目的:逐通道 scale 让模型能更细粒度地控制 memory decay。
缩放定律仍然相关,但容量必须加在正确的位置,并以系统可以使用的形式加入。这个演进过程中的每一种架构,都是为了处理前一个系统中的具体限制而增加容量。
# Kimi K3
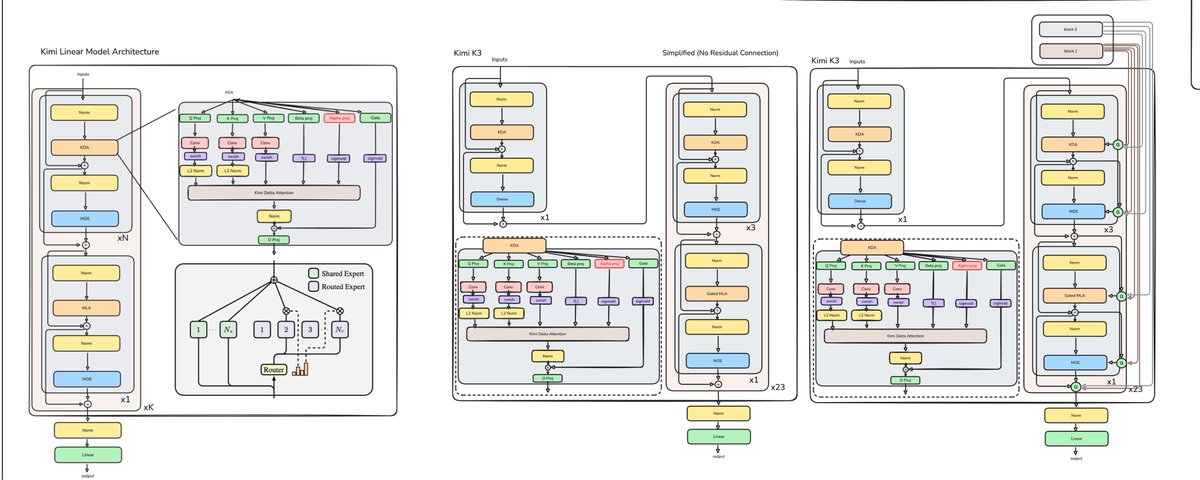
最终,KimiK3 的语言骨干(backbone)看起来和上面的 Kimi Linear 模型相似。它包含 23 个四层宏周期(macrocycle)。在每个 macrocycle 中,三层使用 Kimi Delta Attention,第四层使用 Multi-head Latent Attention。第一层使用 dense feed-forward network;其余每一层都使用 latent Mixture-of-Experts。
乍看之下,相比 Kimi Linear,这些变化似乎不大:
- 规模大幅提升
- 每 12 层加入一次 Blockwise AttnRes
- MLA query LoRA 和 output gating
- Latent-space MoE
- SiTU activations
- Gated MLA
KDA 提供固定状态循环记忆(constant-state recurrent memory),而周期性的 MLA 层保留了对上下文的完整 softmax retrieval。下面这张简化可视化图,可以作为理解后文变化的参考。

我们先从更直接的变化讲起:Gated MLA、latent-space MoE 和 SiTU activations。
Gated MLA 决定从 MLA 取回的每个特征有多少能进入 residual stream。它通过和一个由输入投影得到的 gate 做逐元素相乘来实现这一点。
在传统 MoE 中,一个学到的 router 会用点积相似度(dot-product similarity)把每个 token 发送到一部分 expert network。KimiK3 总共有 898 个 expert。其中 2 个是 shared expert,会处理每个 token;剩下 896 个中,router 会为每个 token 选择 16 个。
KimiK3 还改变了 expert activation。它不再对 up projection 应用 SiLU、再和 gate 做逐元素相乘、然后应用 down projection,而是使用 SiTU:
```
d = x.shape[-1] // 2
gate = x[..., :d].to(torch.float32)
up = x[..., d:].to(torch.float32)
situ_a = self.beta * torch.tanh(gate / self.beta) * torch.sigmoid(gate)
if self.linear_beta is not None:
up = self.linear_beta * torch.tanh(up / self.linear_beta)
return (situ_a * up).to(x.dtype)
```
模型还会先把输入向下投影(down-project)到 shared expert,再把它们的最终求和结果向上投影(up-project)回来:
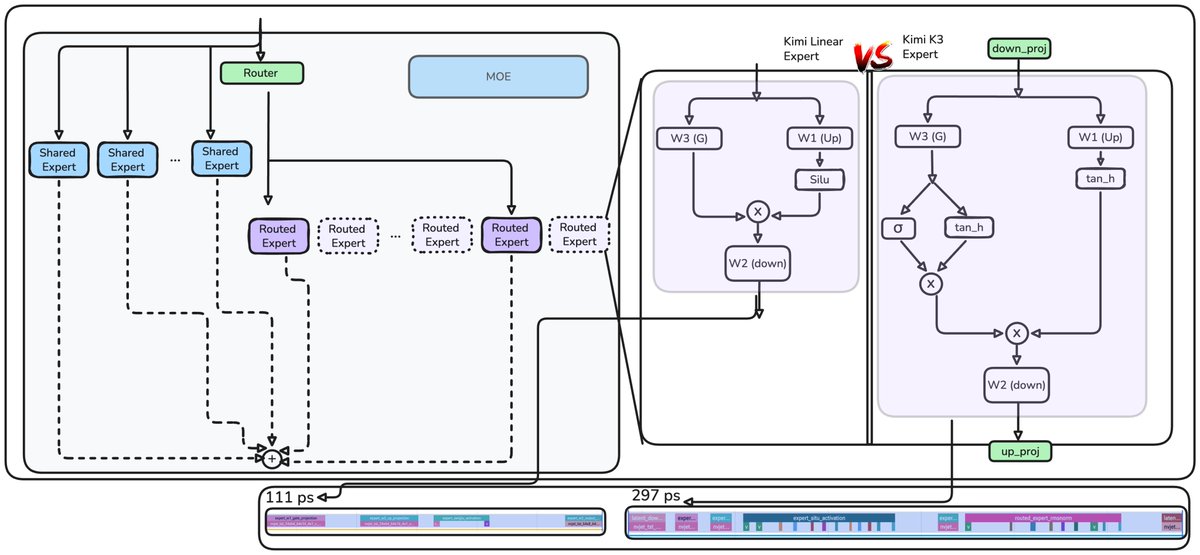
这说明了模型推理中一个反复出现的挑战。如果没有 fused kernel,新的 activation 会比原始路径慢将近 3 倍。一个抵消这种开销的优化是:expert 在压缩的 latent space 中运行,这会让它们的 forward pass 快很多,并且几乎把 FLOPs 减半。
剩下的变化是 MLA query LoRA、output gating,以及每 12 层一次的 blockwise Attention Residuals。AttnRes 会增加大约 2% 的推理延迟,但提供两个重要收益:
- 有选择地取回更早的表示,从而缓解 residual 稀释和隐藏状态增长
- 1.25 倍计算优势
AttnRes 和 MLA 从不同方向处理同一个底层限制。KDA 层使用固定大小的 state,因此不可避免地必须丢弃信息。MLA 从 token context 中检索,而 AttnRes 从更早的深度方向表示(depth-wise representation)中检索。
# AttnRes
感谢 @chloey3k 对本节的帮助。在每次 forward pass 中,输入会经过一组层堆叠。这里,每一层都由一个 attention block(KDA 或 MLA)和一个 MLP 或 MoE block 组成。通常,每一层的输入都是原始 embedding 和之前每一层输出的和,而且所有项权重相同。
$$
h_l = h_1 + \sum_{i=1}^{l-1} f_i(h_i)
$$
这里,h\_i 是第 i 层的输入,h\_1 是当前 token(到目前序列中的最后一个 token)的 embedding,f\_i(h\_i) 是第 i 层的输出(一个 attention 或 MLP block)。
问题在于缺乏选择性访问。不同层类型接收到的是同一个聚合 state,尽管它们可能需要不同的权重分配。由于递推(recurrence)是纯加法的,后面的层还必须学到越来越大的输出,才能影响累积起来的 residual,这可能让训练不稳定。AttnRes 不再平等对待所有层,而是把这个求和中的每一项都乘上一个专门的权重,让模型能根据上下文,对最有用的层赋予更高重要性。
$$
h_l = \alpha_0 \cdot h_1 + \sum_{i=1}^{l-1} \alpha_i \cdot f_i(h_i)
$$
每个权重 alpha\_i 都由 query-key dot product 计算得到。query 针对每一层学习得到,而 key 和 value 来自更早的 residual-stream state。分数会被归一化,使总和为 1,然后用于形成这些 state 的加权组合。
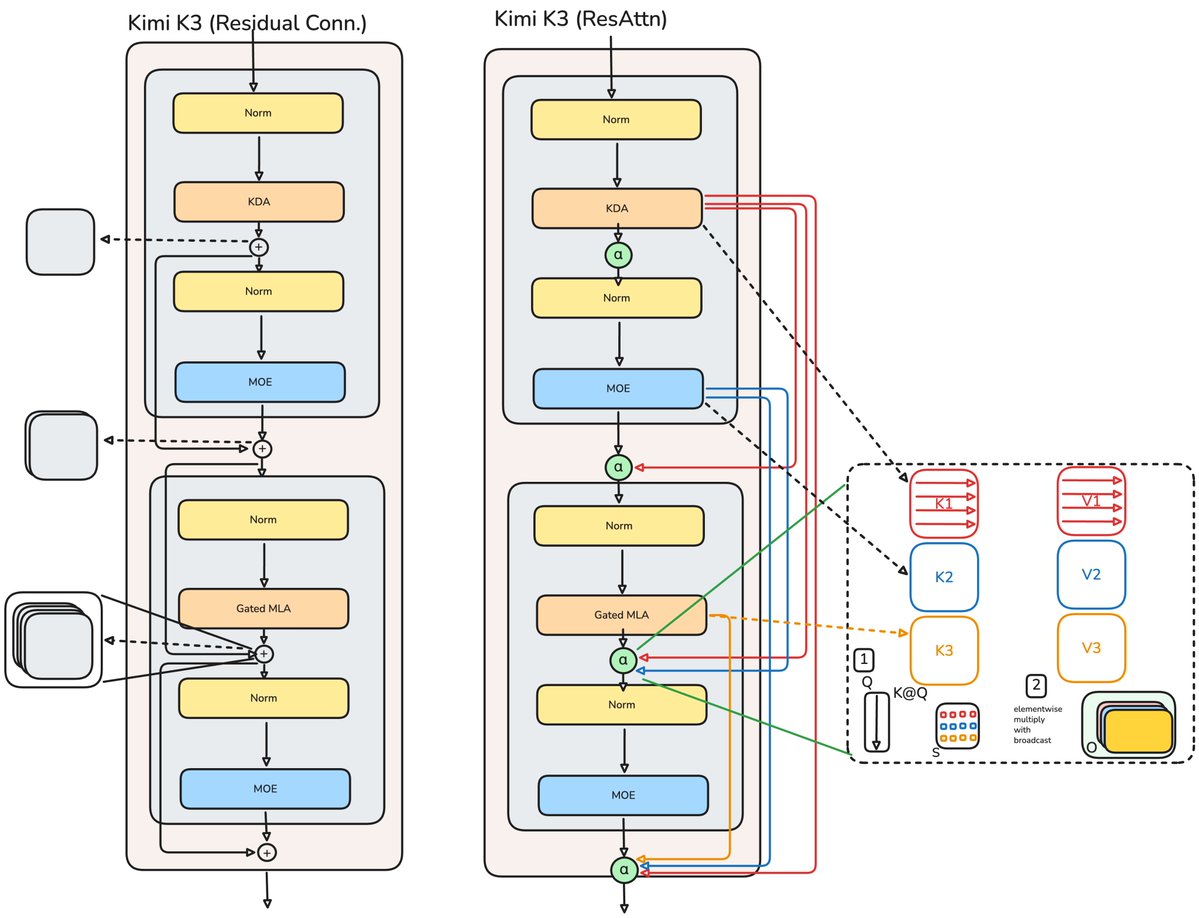
因此,模型不必只基于自己的直接前驱进行条件化。AttnRes 让每一层都能有选择地访问更早层的输出,使它学到的 query 可以取回对当前计算最有用的表示。
下面的伪代码在 block 粒度上应用了同一个思路。一个 block 是跨 12 个 decoder layer 累积起来的 attention 和 MLP 输出的逐元素和,会作为单个深度表示存下来,供后续 AttnRes 混合使用。
在每一层都应用 residual attention,会增加太多训练和推理成本。只在固定 block 边界上应用它,可以用更低成本捕捉大部分收益。在 KimiK3 中,每个边界出现在 12 个 decoder layer 之后。跨 23 个四层 macrocycle,这会产生 8 个 AttnRes blocks,从而提高推理速度。
这是 block\_attn\_res 函数里可能最重要的一部分:
```python
V = torch.stack(blocks + [partial_block]) # [N+1, B, T, D]
K = norm(V)
logits = torch.einsum('d, n b t d -> n b t', proj.weight.squeeze(), K)
h = torch.einsum('n b t, n b t d -> b t d', logits.softmax(0), V)
return h
```
这就完成了从 GPT-2 到 KimiK3 的演进。
核心变化并不只是规模。每一步架构变化,都改变了模型存储什么、如何更新这个 state,或者如何取回固定大小 state 无法保留的信息。
KimiK3 结合了固定状态循环记忆、周期性的 softmax retrieval、稀疏专家容量,以及选择性的 depth-wise residual access。结果是一个会把额外容量花在特定功能位置上的系统。
本质上,固定容量的关联记忆(固定维度)需要一种 eviction policy,因为纯加法线性操作一旦达到容量上限,最终就会引入干扰。为此,像 gating、routing 或 decay 这样的学习式选择是必要的,而 attention 是最有效的选择性读取机制。