Lauren Tan 在 X 上以 @poteto 为人所知。她向生产环境提交了 3,000 多个拉取请求(PR),而她所在的整个团队在过去一个月里提交了约 11,000 个。
不寻常之处不在于 PR 数量有所增加,而在于被拒绝的 PR 数量反而减少了。
事情是这样的: 几天前,她在旧金山举行的 AI Engineer Code Summit 上详细解释了自己和团队究竟是如何做到这一点的,
她把演讲命名为“所有代码都是垃圾(除了我的)”。
下面是对这场演讲的完整拆解,以及一份如何用智能体正确写代码的实用指南。
另外,我会把自己认为最重要的一些内容标为 [规则],一定要记住。
把它保存下来,因为你会想回来重看的:

所有人的代码都是垃圾
Lauren 用一个几乎每位开发者都能会心一笑的笑话开始了演讲。
我们自己写代码时,会称之为“精心之作”。别人做完全相同的事时,我们却称之为“垃圾”。
她想表达的是,“垃圾”其实根本算不上一个定义。它只是我们用来描述那些不是自己写的、自己也没有完全理解的代码的词,但许多人却给它附加了另一种错误的含义。
早在智能体出现之前,代码库里就一直充斥着人类写的垃圾代码。所以,真正的问题并不是 AI 写的代码是不是“垃圾”。
真正的问题是:你是否建立了一套系统,能把这些代码转化成你真正可以信任的东西。

演讲背后的数字
为了说明这不只是理论,Lauren 在屏幕上展示了自己的数据。3 月,她提交了 68 个 PR(拉取请求)。
7 月:1,113 个 PR
8 月:2,401 个 PR
10 月:3,127 个 PR
总计:10,732 个 PR(从 3 月算起)。
我们来算一下:
每月 3,000 个 PR = 每天 100 个 PR
没有任何一个人能独自处理这么多
但最有意思的是她如何做到这一点:
她并不是简单地延长工作时间、使用更多智能体。她花了大约半年时间围绕智能体的工作建立一套系统,正是这套系统让她能以如此高的速度提交 PR,同时又不牺牲质量。

这就引出了她演讲的核心观点:
智能体出现之前,只有少数出色的工程师能以这种规模产出产品,他们被称为“编程机器”。现在,任何人都可以成为这样的人。
如今的关键能力不是打字更快,而是在不牺牲质量的前提下迅速把产品推向市场。

一切都归结于信任
Lauren 认为,一切都可以归结为一条曲线。
你越信任自己的智能体,就越能同时运行更多智能体:
> 如果信任程度低,就运行一个智能体并监控它。
> 如果信任程度高,就运行数百乃至数千个智能体。
但只有当你信任它们,相信到不需要逐行阅读每一行代码时,你才能同时运行大量智能体。
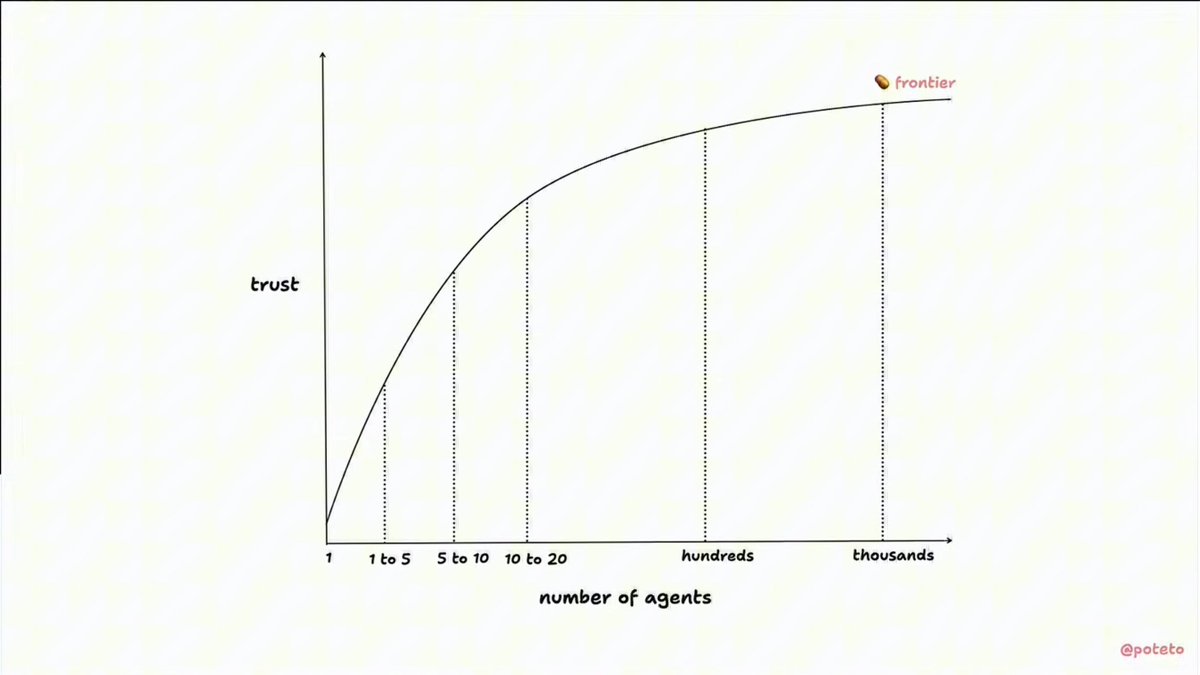
问题在于,大多数人都被困在这条曲线的底部:
智能体写出垃圾代码,人类审查,发现错误,退回修改,然后这个循环无休止地重复。
在这个循环里,人类永远是“瓶颈”。
核心目标则是进入另一个循环:智能体写出高质量代码并检查自己的工作,而你只在真正需要自己判断时才介入。

Poteto 金字塔
那么,怎样才能从一个层级进入下一个层级?
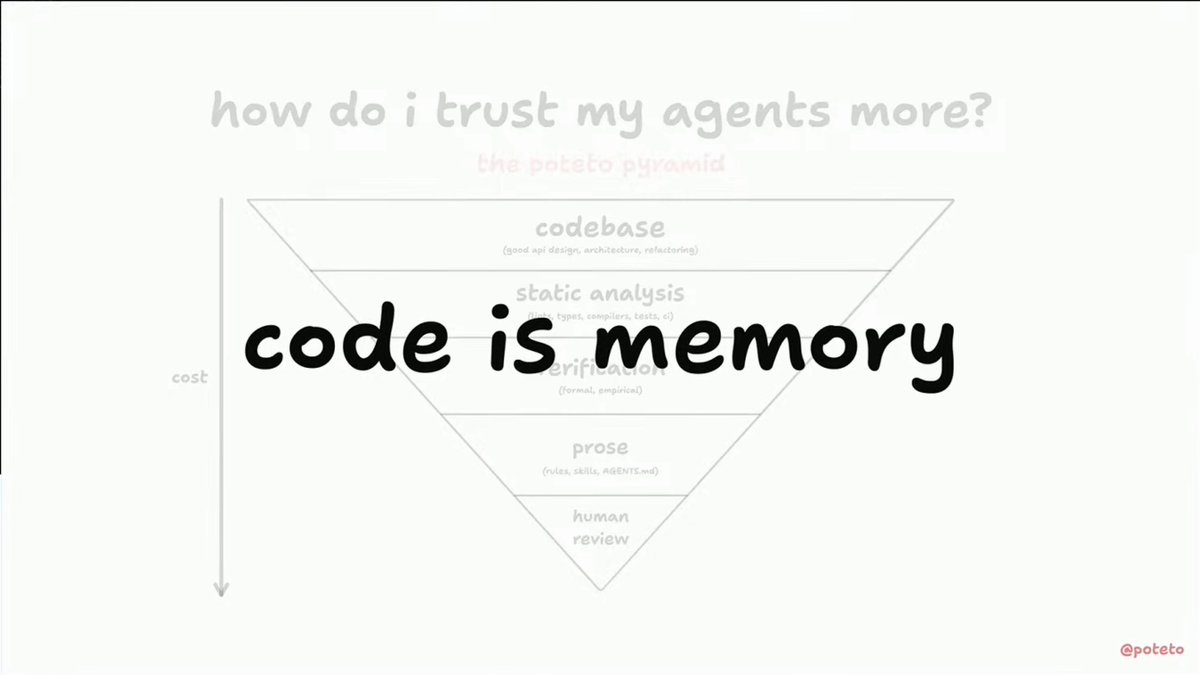
Lauren 用一个倒金字塔来解释:
- 顶层是代码库本身:设计良好的 API、清晰的架构和定期重构。
- 静态分析:lint 规则、类型、编译器、测试和 CI。
- 验证,包括形式化验证和运行时验证。
- 文档:规则、最佳实践和 AGENTS.md 文件。
- 人工审查
道理很简单:
越靠上的层级越值得投入精力;越往下,每次修复的成本就越高。
大多数人的做法恰恰相反。他们不断扩充 AGENTS.md 文件,事事都靠人工检查。这是成本最高、得到的信心却最低的做法。

代码就是记忆
正是这个观念从根本上改变了你对整个项目的看法。
智能体从代码中学到的东西,比你提供给它们的任何其他材料都多。每一种临时变通、每一个“快速修补”、每一笔技术债,都会悄悄变成下一个智能体照着复制的模板。
规则 1:你的代码就是智能体的记忆。
Lauren 把代码库比作一座花园:
代码不再以少量整齐 PR 的形式进入,而是像水流一样源源不断地涌入。
2024 年时,她每天可能只需审查三个 PR;如今,这个数字正接近三百个。
在一座以这种速度生长的花园里,今天被你忽略的一株杂草,下个月就会蔓延得到处都是。所以,保持代码库整洁比以往任何时候都更加重要,这样智能体才总能找到值得效仿的好例子。
规则 2:你仍然应该时不时读一读代码。

Dune:为智能体打造的框架
为了把上述理念落到实处,团队创建了 Dune,也就是 Grok Bot 运行所依赖的框架。你可以把它理解成面向 Electron 应用的 Next.js。
这个框架本身没有什么魔法,它的独特之处在于内置的约束:
每项功能使用一个文件夹;严格限制哪些内容能从哪里导入;代码里完全没有注释。
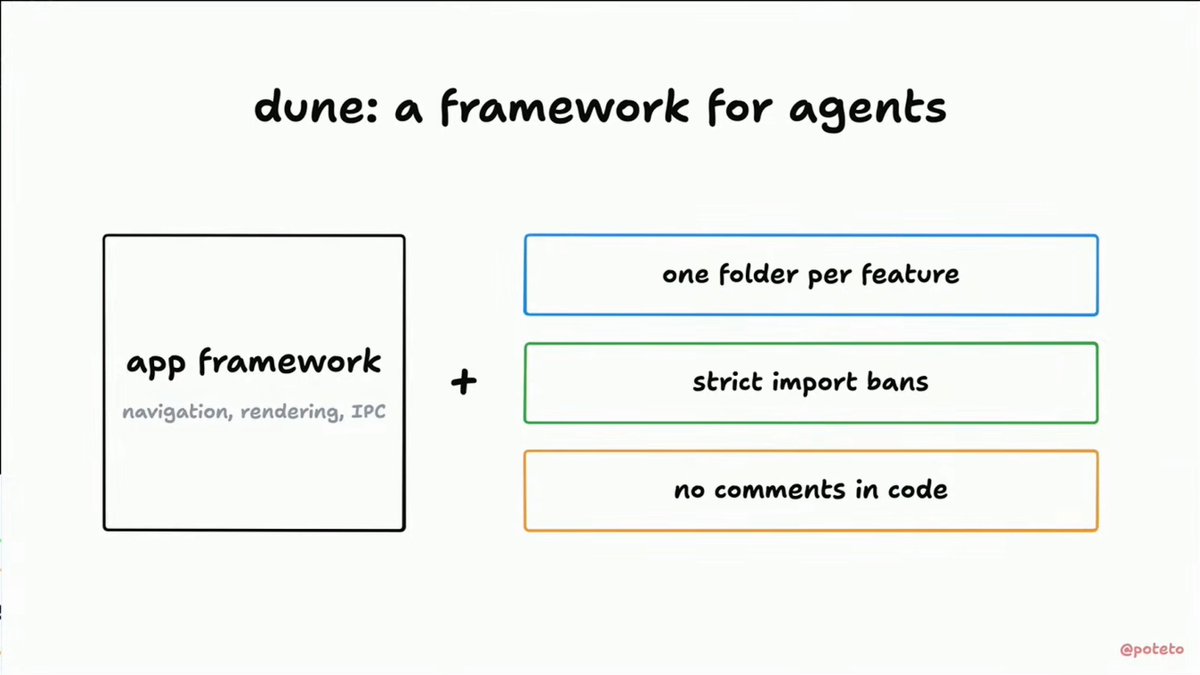
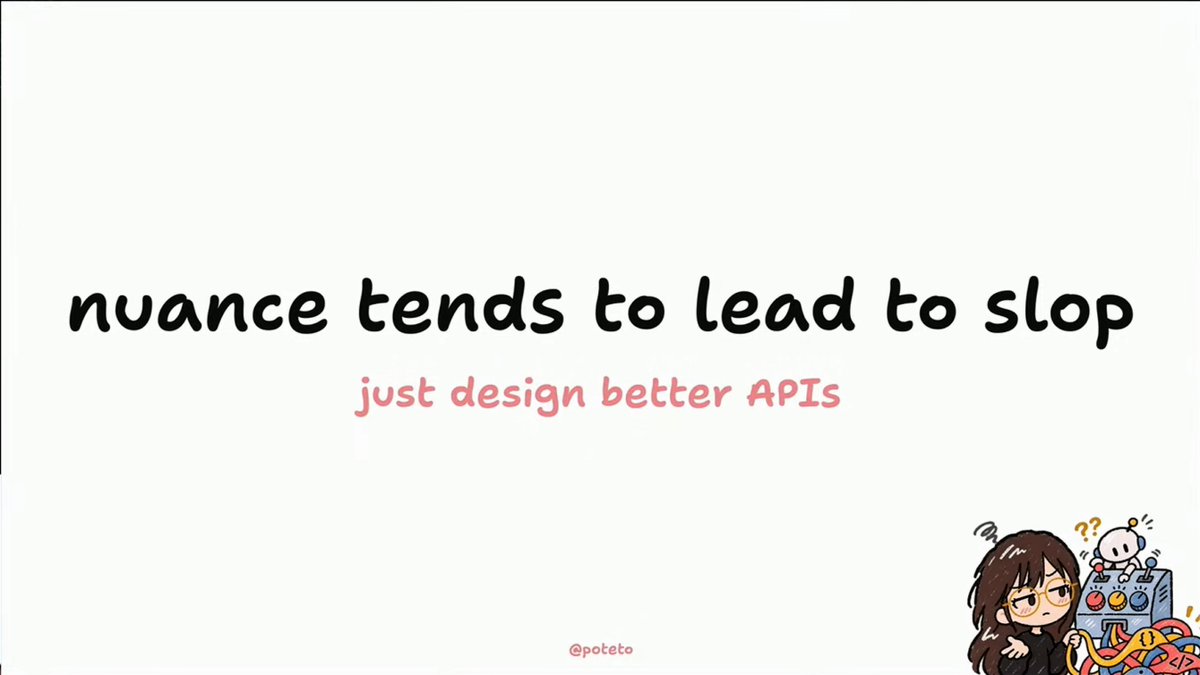
我们能从这些约束中得到的一个教训是:细微差别往往会导致疏忽。
任何需要仔细判断才能正确使用的东西,迟早都会被智能体用错。
Lauren 最喜欢举的例子是 React 中的 “useEffect” 函数。
它很有用,但也太容易被误用了,以至于人们开玩笑说:
“你得有博士学位才能正确使用它,而开发者又总是在这里犯错。”
所以,团队直接禁止在产品代码中使用它,只允许 Dune 的内部机制使用。
一整类错误就这样消失了,代码审查时也再也不用寻找这类错误。
他们没有向开发者解释其中的细微差别,而是构建了一个根本不存在这些细微差别的 API。
文件夹也是同理。在 Cursor 项目中,团队一再遇到一种低效做法:
智能体把 Electron 主进程中的代码导入渲染进程,导致任务执行时间过长、UI 延迟。
在 Grok Bot 中,文件夹结构本身就会告诉智能体允许做什么。渲染进程和主进程位于不同的文件夹,完全不能相互导入数据,连类型也不行;它们之间唯一的桥梁,是存放公共类型的共享文件夹。
Lauren 甚至把这种方法用在了自己的副项目中:任何名为 tick(.)hot.ts 的文件都会在每个 tick 执行,因此不允许分配内存。

当智能体开始找借口
最让 Lauren 意外的是智能体使用 Markdown 的方式。它们会把帮助文件、注释和笔记当作解释自己为何没有按正确方式做事的地方。或者完全走向另一个极端:你只给它们一条小小的指示,它们却把这当成一条永远不得违反的不可变法则。
Lauren 甚至把这种方法用在了自己的副项目中:任何名为 tick(.)hot.ts 的文件都会在每个 tick 执行,因此不允许分配内存。

如果不这样做,事情就会变成下面这样:
9 月 9 日,一位开发者用一次快速的 setTimeout 调用修复了界面闪烁问题,并留下一条注释,表示妥善修复“需要进行更大规模的改动”。
10 月 3 日,同样的变通方案被复制进了共享模块。
到了 10 月 17 日,应用里已经有 183 个计时器。
以如此高的频率创建和销毁计时器,会迫使系统进行密集的垃圾回收,表现出来就是延迟和卡顿。
一次由一条注释辩解的垃圾修复,在大约五周内扩散到了整个应用。
规则 3:不要让智能体用 Markdown 写没人要求它写的东西。

这正是 Grok Bot 团队删除几乎所有注释的原因。
注释会过时,人们很少阅读它们,开发者还会拿它们为糟糕的代码辩解。
最糟的是,注释规范根本无法强制执行。
7 月 31 日,代码库中有 65,824 条注释;如今只剩 1,227 条。
如果你也想这样做,Lauren 的 pstack 插件提供了专门用于此目的的 /no-comments 命令:GitHub
规则 4:用智能体写代码时,绝对不要写注释。
这不适用于你自己写的代码或学习时的代码。另外,如果你在团队中工作,那么你很可能仍然必须写注释,因为这长期以来一直是标准做法。
但随着时间推移,我们很可能会逐渐抛弃这种既有惯例,再也不写注释。

改变一切的一条规则
这场演讲最重要的结论是:
重要规则:每当你修复智能体写的代码时,不要再往规则文件里加一行内容。
把这次修复变成一条 lint 规则,或者重构代码,让这种错误无法再次发生。她的团队自定义 lint 规则的数量从 7 月的 7 条增长到了 11 月的 167 条,而每条规则都代表一种再也不必手动发现的错误。
足够频繁地这样做,你就会发现需要检查的东西越来越少。到了某个时刻,你会意识到几乎已经没有什么可检查的了;也正是在这个时候,智能体开始能够自行提交大部分工作。

验证是最重要的一步
第二个重要教训与代码审查有关。
Grok Bot 团队如今的代码审查主要是在分析辅助材料:视频、截图、图表和形式化证明。
但肯定不是逐行阅读每一行代码。

为了说明这一点为什么重要,Lauren 引用了 Cindy Sridhar(@copyconstruct)相隔六个月发布的两篇帖子。
5 月,Cindy 感到很沮丧,因为她的团队合并了几个包含隐蔽错误的 AI 生成 PR,而修复这些错误又耗费了数天的人工审查。
她得出结论:如果把后续修订耗费的所有时间都算进去,“速度”其实并没有提高。

11 月,她重新谈到此前的观点,并表示自己已经不再遇到这些问题。
只有一件事发生了变化:她建立了妥善的验证流程。
她每天大约 70% 的 token 如今都用于验证补丁,只有 20% 至 30% 用于编写补丁。
Lauren 表示,这也准确反映了她自己的经历。

Cindy 所说的“验证”,是指覆盖所有阶段的一整套方法:从单元测试和发布前的模糊测试,到“金丝雀”部署与发布后的监控。
有意思的是,这些方法没有一个是新鲜事物。
清单上的每一项都是经典的软件开发方法,只是过去实施和维护的成本太高、太耗费人力。
智能体让这些方法变得触手可及,因此 Lauren 认为,我们正在进入测试的“黄金时代”。

让智能体检查自己的工作
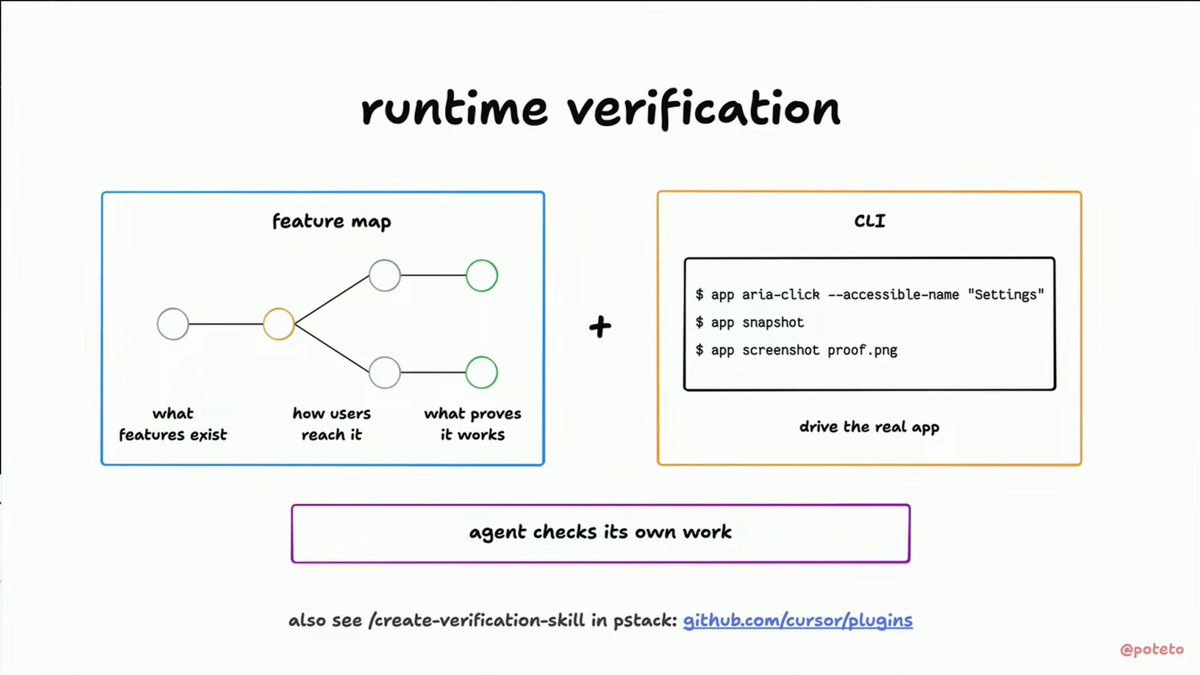
在 Grok Bot 团队中,测试从执行阶段就开始了:智能体必须能够启动实际应用,并验证自己的工作结果。
这是由两个组件实现的:
1)功能地图
它描述了有哪些功能、用户如何访问这些功能,以及用什么来确认每项功能都能正常工作。
2)命令行工具
它通过按名称点击按钮、截取屏幕截图并将其保存为证据,来控制实际运行的应用。
由于这些工具可以重复使用,它们也能节省 token,因为智能体不需要每次都重新创建它们。
在 pstack 中,可以使用 /create-verification-skill 命令配置这套流程。
此外,团队还在试验形式化验证:
他们使用 TLA+ 为状态机建模,例如跨设备同步的通知,并验证所有可能的状态都得到了处理。
他们使用 Lean 根据代码生成证明,例如确保自己的虚拟化库不会导致闪烁或抖动。
Lauren 很谨慎,没有把它称为“万灵药”,因为它只是又一层保障,但它已经帮助团队发现了真实的 bug。
pstack 还提供了 /create-formal-verification-skill 命令。

最后一步是使用 Bombadil 库,根据界面的属性测试界面本身。这个库会用随机输入数据对应用进行高强度压力测试,以发现潜在故障。
链接: github.com/antithesishq/bombadil。

这一切最终带来了什么
那么,所有这些投入为 Grok Bot 团队带来了什么?
上个月,他们向生产环境推送了约 11,000 个 PR;如今,他们大约每天都会发布一个新的稳定版本。
仅在 10 月,就有 227 人至少提交了一个 PR。
只有约 0.5% 的 PR 会被拒绝,而应用确实随着时间推移变得更快了:启动、文本输入,以及打开和切换聊天的速度,都比项目刚发布时更快。
团队每次发布新版本时,Grok Bot 都会自动运行 Cursor 项目。它会像真人一样使用应用,寻找 bug,为每个 bug 创建修复方案,然后自行提交这些修复。
这之所以可行,只是因为如今的代码库已经足够好,大多数拉取请求在默认情况下就是高质量的。
这对你意味着什么
记住这些规则:
规则 1:你的代码就是智能体的记忆。
规则 2:你仍然应该时不时读一读代码。
规则 3:不要让智能体用 Markdown 写没人要求它写的东西。
规则 4:用智能体写代码时,绝对不要写注释。
重要规则:每当你修复智能体写的代码时,不要再往规则文件里加一行内容。
Lauren 的最后结论:
如果你的智能体循环生成的是“垃圾”,把它自动化也解决不了任何问题,只会制造更多“垃圾”,还会额外浪费资源。
开始建设自己的“软件工厂”之前,先夯实基础:把每次调整都变成一项检查而不是一条规则;禁用任何太容易被滥用的东西;让文件夹结构传达上下文;去掉注释;让智能体证明自己的工作确实有效。
她花了六个月才走到这一步;她保证,你需要的时间会短得多。
附言:我一直在拆解这类与 AI 和智能体有关的内容。
如果你想在信息流里看到下一篇,欢迎关注我 @0x_kaize。