---
title: "你的 AGENTS.md 就是一个神经网络"
author: "Kun Chen"
source_url: "https://blog.kunchenguid.com/p/your-agentsmd-is-a-neural-net"
published_at: "2026-08-23T04:09:12.794Z"
fetched_at: "2026-08-26T16:09:10Z"
updated_at: "2026-08-26T16:12:41Z"
language: "zh"
review_status: "draft"
---
# 你的 AGENTS.md 就是一个神经网络
以及如何用梯度下降把它训练好
很多人都觉得 `AGENTS.md / CLAUDE.md` 很难维护。我问别人怎样才能把它维护好,得到的坦白回答通常是:“我把自己认为 agent 应该知道的东西写进去”,或者“我让 agent 替我写”。
很长一段时间里,我也一样,全凭感觉。但我知道一定能找到更好的办法。这篇文章介绍的,就是我最后摸索出来的方法。
简短版是:用户级 AGENTS.md 用来记录你自己的偏好,应该由你亲手编写;项目级 AGENTS.md 则要当成神经网络来对待。给它设定容量预算,再用真正运行过的会话来训练它。
下文会具体解释这是什么意思。
## 四种糟糕的状态
随便打开一份用了几个月以上的项目记忆文件,通常都逃不过下面四种状态:
- **空白。** 文件只是某个工具顺手创建的。agent 读不到任何有用信息,每次会话都要重新摸索同样的事情。
- **臃肿。** 每当 agent 干了件蠢事,就有人往里面追加一条规则。一年后,文件长到 900 行。从此以后,每次会话都得为这 900 行付出成本,没完没了。更糟的是,文件越长,指令遵循效果越容易被稀释;真正重要的规则,会被埋在大量无关紧要的规则下面。
- **过时。** 一半规则描述的构建系统早已被替换。agent 仍照着旧指令行动,平白犯下本可避免的错误。
- **互相矛盾。** `AGENTS.md` 说一套,`CLAUDE.md` 说另一套,而你当天使用的 harness 又拿到一套不同的指令。
共同的问题在于,人们往往根据零散经历,遇到一件事就改一次文件;追加内容很容易,归并和删减却难得多。
但用来判断该改什么的数据其实早就有了。每次 agent 会话都会在磁盘上留下记录。Claude Code、Codex、pi、opencode、grok、Cursor 都会记下:用户要求 agent 做什么、它做了什么、遵循了哪条规则、被哪条规则绊倒、用户怎样纠正它,以及它不得不重新发现什么。
## 两类文件,两种截然不同的任务
首先要知道,agent 记忆文件可以写在两个层级,而这两个层级应该采用完全相反的处理方式。我的理解是这样的。
**用户级文件属于我,由我亲手编写。** 我的全局 `~/.claude/CLAUDE.md or ~/AGENTS.md` 记录的是个人偏好和主张:质量优先于开发成本;修 bug 前先端到端复现;即使不归你负责,路过一个不稳定测试也要顺手修好。这些偏好由我决定,而且很少变化。别人不该编辑,工具不该“优化”,尤其不该交给 agent。这份文件有意保持简短,也有意坚持手写。
**项目级文件其实就是一个神经网络。** 它会被载入这个项目中各次 agent 会话的 system prompt,对 agent 行为的引导作用,很像叠加在所用模型之上的微调 LoRA。与其把它当普通文件编辑,不如先定好 token 预算,再像训练神经网络一样认真训练它。
## 前向传播与反向传播
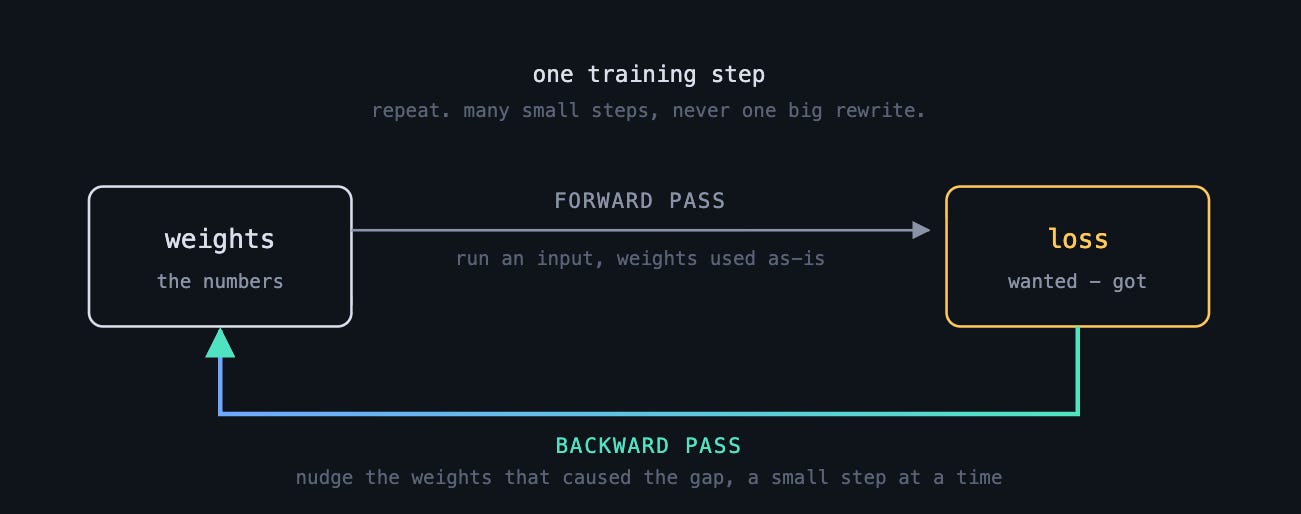
如果你从未训练过神经网络,完整循环其实就是这样:
1. 网络拥有**权重**:一组决定它如何运行的数字。
2. 把一份输入送入网络,这就是**前向传播**。权重直接按现状使用,不作任何修改,网络随后给出输出。
3. 将输出与预期结果比较,两者之间的差距就是**损失**。
4. 从损失反向追溯,找出哪些权重造成了差距,再把每个权重朝着能缩小差距的方向轻微调整。这就是**反向传播**,每次微调叫作一个**梯度步**。
5. 重复这个过程。每次迈一小步,而不是一次彻底重写。步幅就是**学习率**;太大会来回震荡,太小则始终没有进展。
接下来有两个细节很重要。第一,不要根据单个样本更新,因为孤例只是个别经验,还可能带有噪声;要攒成一批再处理。第二,网络大小是固定的——网络越大,能存储的知识越多,但推理成本也越高。
## 一一对应起来
现在把其中的名词替换一下:
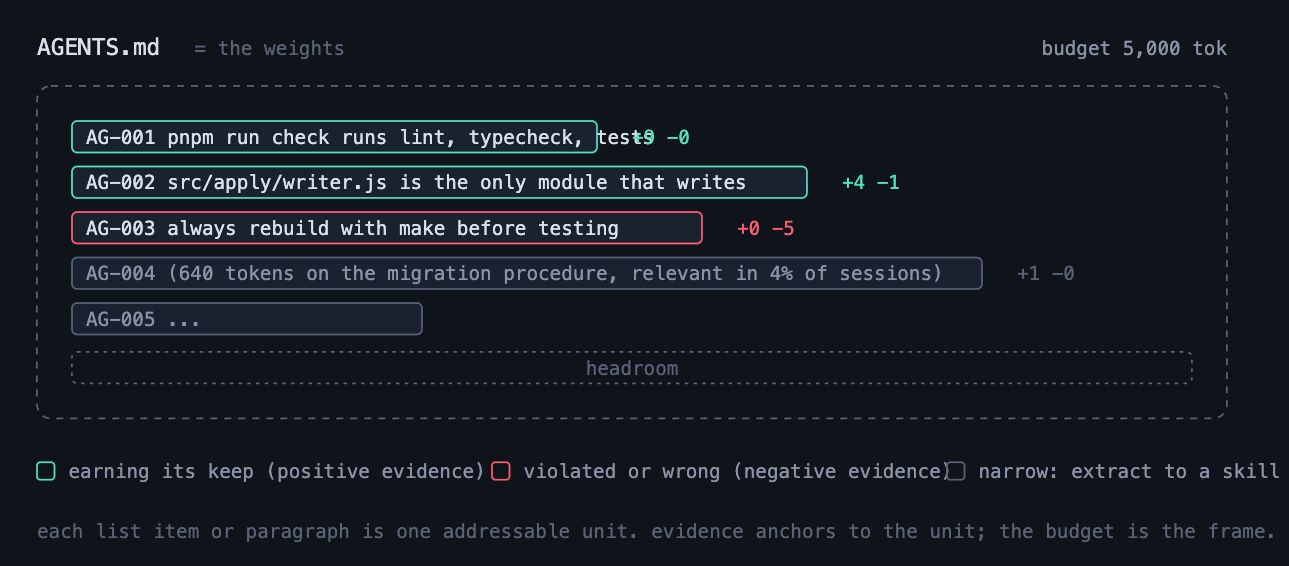
- **项目级** `AGENTS.md` **就是权重。** agent 甚至还没读取一行代码时,这份文件就已经决定了它会在这个 repo 里怎样行动。
- **预算就是“模型大小”。** 模型越大,能容纳的知识越多,也可能给出更好的结果,但推理成本会随之上升。因此,明确设定预算很重要,它能让这项取舍摆到台面上。
- **每次 agent 会话都是一次前向传播。** agent 载入文件、完成工作,文件本身不会被改动。
- **agent 的实际行为与预期之间的差距,就是损失。** 它又重新摸索了一遍 schema;repo 明明使用 pnpm,它却运行了 `npm test`;它违反了一条明明写在文件里的规则;它遵守的某条规则后来却被证明是错的。所有这些都会留在会话记录中。
- **读取会话记录并更新 AGENTS.md 文件,就是反向传播。** 找出哪些指令造成了损失、哪些指令确实发挥了作用,再在预算范围内小幅更新权重,缩小损失。
可以看到,两者相似得惊人。把 AGENTS.md 这样理解,也正好符合一个现实:大多数人其实不会经常仔细阅读其中的内容。实际使用中,它早已是一个黑箱。
目前缺少的环节是:大多数人只做了前向传播——每次 agent 会话都会使用 AGENTS.md——却没有根据损失做反向传播,持续调整权重。
## 实际怎样做一次反向传播
这件事可以手动完成,我自己也这样做过一段时间。整套做法分为五部分,每一部分都能在训练循环中找到对应环节。
**证据来自会话记录,而不是零散印象。** 损失信号应该来自 agent 的会话日志,而不是你回想起上周二被它气到的那一刻。把 AGENTS.md 中的每个列表项或自然段都视作一个可单独定位的单元,然后逐项追问:它在哪些会话中真正产生了影响?有没有被遵守?有没有被违反?它本身是不是错的?还要反过来问:agent 犯过哪些错误,却没有任何单元覆盖?
**攒够一批数据再更新。** 一次糟糕的会话可能只是偶然,绝不能因此重写权重。只有拿到一批数据,才能分清什么是真正反复出现的模式,什么只是噪声。单是这条约束,就能消除大部分臃肿内容,因为许多被随手贴进去的规则,都只是针对某次再也没有重现的事故作出的反应。
**每次只迈一小步。** 每轮只做少量修改,比如五处;每一处只能是新增、删除、重写,或抽取成 skill,而不是重写整份文件。记忆文件一旦改动太大,就和推倒重来没有区别,原本有效的内容也会一并丢失。
**遵守预算,用 skill 来分流。** 为始终会被载入的文件设定预算,例如 5,000 个 token。达到或接近上限后,更新就成了零和取舍:每次新增内容,都要明确靠删除哪一项或把哪一项抽成 skill 来腾出预算。skill 就是分流出口。适用范围广的指令——例如在大约 20% 或更多会话中都适用,或事关安全——留在记忆文件里。范围窄、又有明确触发条件的指令变成 skill;范围窄却没有可识别触发条件的指令,则应考虑删除。
严格地手动执行这套方法,确实比根据零散经历随意修改要好得多。但它很繁琐:查找会话记录、阅读数 MB 的工具调用杂音、确保引用不失真、计算 token。这些工作才应该交给工具。
## 完成反向传播的工具
因此,我做了 [backpass](https://github.com/kunchenguid/backpass),用来轻松、可重复地运行这套循环。在最近处理过的 repo 中执行 `npx -y backpass` 就能使用。
它的结构,就是把前面的方法变成一条流水线。每运行一次,就是迈出一个梯度步。
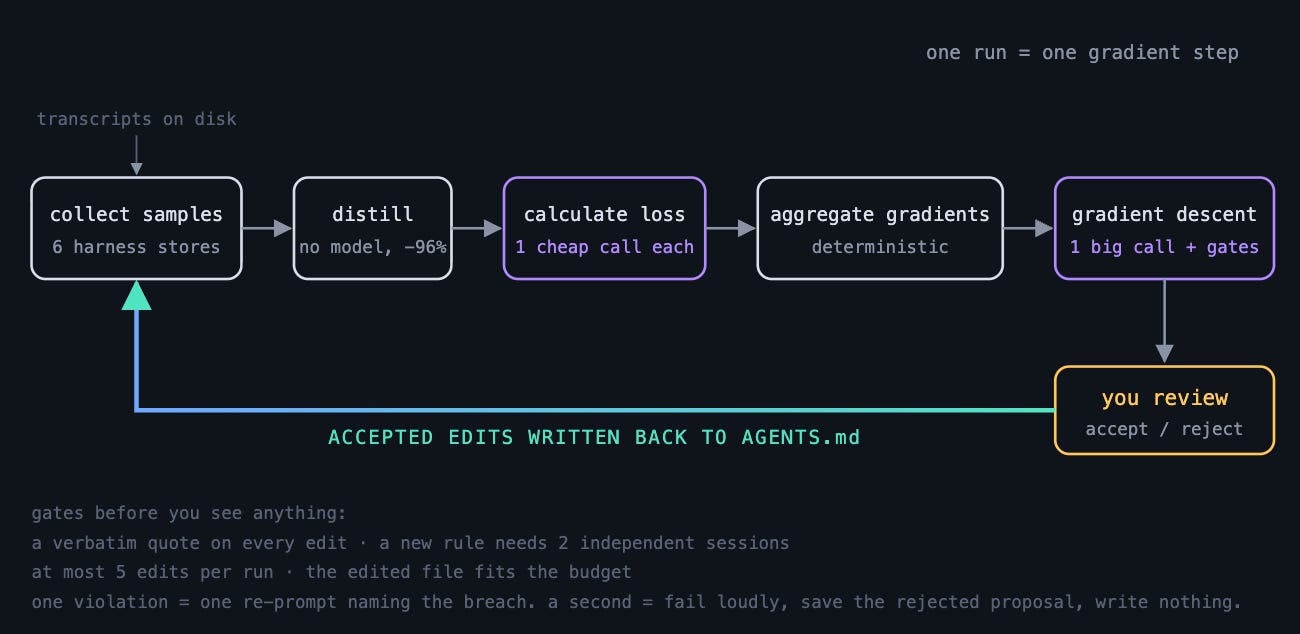
- 它直接从磁盘读取常见 agent harness 的本地会话记录库,并通过 cwd 或 git remote 把每次会话关联到相应 repo。
- 它把每份会话记录浓缩成真正承载损失信号的内容——用户要求了什么、agent 说了什么,以及每次工具调用的一行概况。这个过程不使用模型,就能把内容减少 96%–99%。随后,每份会话记录只需调用一次低成本模型来计算损失,并产出针对每个可定位单元的证据;凡是没有逐字引文支撑的内容,都会由代码丢弃,而不是交给 prompt 判断。
- 梯度以确定性方式汇总:统计每个单元的正负计数和相关性占比;把不同会话中近似重复的缺口归为一组;任何只在不到两次会话中出现的缺口都会被丢弃。
- 随后进入梯度下降步骤:一次高推理能力的模型调用提出修改建议,各项关卡则机械执行——最多修改五处;新增规则至少要有两次会话作为依据;每项修改都必须附上引文;修改后的文件必须符合预算。一旦违反约束,只会重新提示一次,并明确指出违规之处;第二次仍然违反,就直接报错,什么也不写。token 变化量根据实际文本测量,因为模型自己报告的数字从来不值得相信。
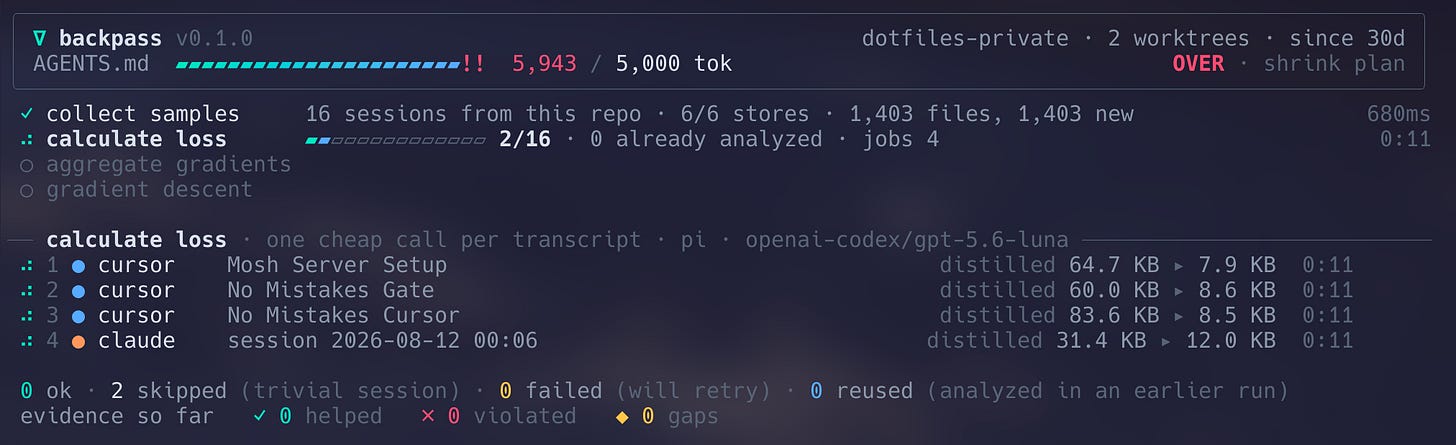
在我审核之前,工具不会写入任何内容。`backpass apply` 使用 lavish-axi 展示修改建议列表,每项都附带 diff 和证据。我会逐项接受或拒绝;被拒绝的建议也会被记住,除非出现新证据,否则不会再次提出。这些参数就是训练旋钮,只是用了它们对应的真实名称:`--budget` 是模型大小,`--max-edits` 是学习率,`--min-gap-evidence` 是批量大小,`--since` 是训练窗口。
我最终形成的节奏是:每个活跃 repo 每周运行一次,阅读建议,拒绝模型越界的部分,接受其余部分。时间一长,AGENTS.md 会变得越来越精简,也越来越有效。
## 为什么我认为这种结构是对的
早在一年前,任何人都可以让 agent“清理一下这个文件”。真正重要的是这里面的科学严谨性:只用真实会话记录作为输入;只接受逐字引文作为证据;预算固定;每次步幅很小;设置最小 batch;必须经过人工关卡才会写入。
如果你想试试,可以在 repo 中运行 `npx -y backpass`。这个工具也已经按 MIT 许可证开源。如果想研究它所自动化的循环,可以访问 [github.com/kunchenguid/backpass](https://github.com/kunchenguid/backpass)。