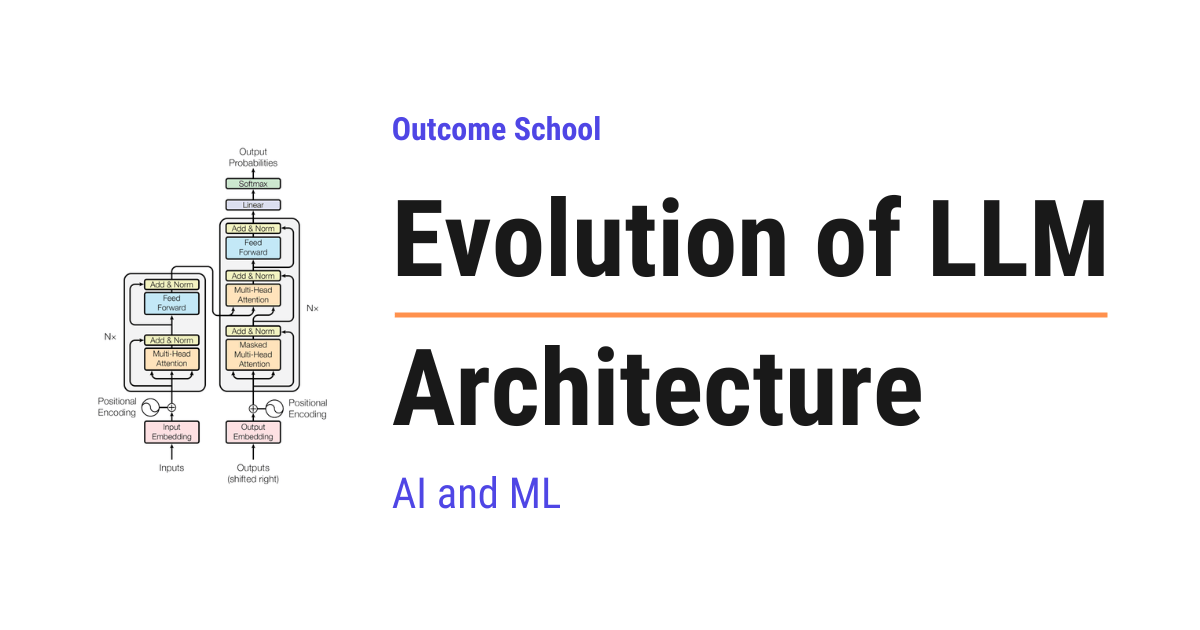
本文将介绍 LLM 架构的演进,逐步回顾大语言模型如何从一次只读一个词的简单设计,发展成我们今天使用的庞大 AI 模型。我们还会看到:早期模型为什么总会遗忘,注意力机制如何解决这个问题,Transformer 如何移除拖慢速度的部分,扩大模型规模为什么能让模型变得更聪明,混合专家模型如何降低大模型的运行成本,目前还存在哪些问题,以及接下来可能出现什么。
本文将涵盖以下内容:
- 什么是 LLM 架构?
- 第一阶段:一次读取一个词(RNN)
- 第二阶段:注意力机制
- 第三阶段:Transformer
- 第四阶段:规模扩展
- 第五阶段:混合专家模型(MoE)
- 第六阶段:新方向
- 演进历程总结
我是 Amit Shekhar,Outcome School 创始人。我教过并指导过许多开发者,他们凭借自己的努力获得了高薪技术工作,帮助多家科技公司解决了各自的难题,还创建了许多被头部公司采用的开源库。我热衷于通过开源项目、博客和视频分享知识。
我在 Outcome School 教授 AI 与机器学习。
现在开始吧。
什么是 LLM 架构?
LLM 架构是大语言模型的蓝图。它描述模型如何读取文本、如何记住读过的内容,以及如何生成下一个词。
我们先拆开这个名称来看。
LLM = Large(大)+ Language(语言)+ Model(模型)
- Language(语言):它处理的是文本,也就是我们每天读写的词语。
- Model(模型):它是一种计算机程序,已经从海量文本中学会了规律。
- Large(大):它从极其庞大的文本中学习,并拥有数量极其庞大的内部参数。
架构就是设计。假设我们要盖一栋房子,架构就是那份规划:房间放在哪里、门要开多大、水路怎样铺设。每栋房子用的都是砖块和水泥,但规划决定了房子最终好不好。
LLM 也是如此。不同模型所用的数字和数学原理大致相似,但架构决定了模型如何读取、记忆和回答。
LLM 架构的每一次重大进步,都是因为之前的设计存在问题。
- 最早的模型会忘记自己读过的内容。
- 后来,注意力机制解决了遗忘问题,但模型仍然很慢。
- 再后来,Transformer 让模型快了起来,但没人知道模型究竟该做多大。
- 随后,规模扩展让模型更聪明了,运行成本却变得太高。
- 接着,混合专家模型降低了成本。
- 而这段演进仍在继续。
所以,理解今天的 LLM,最好的办法就是沿着这条时间线走一遍,每次看一个问题,再看一个解决方案。
别担心,下面会逐一详细讲解。
第一阶段:一次读取一个词(RNN)
在 Transformer 出现之前,读取文本最流行的设计是 循环神经网络(Recurrent Neural Network,RNN)。
神经网络是一种计算机程序,由大量相互连接的数值组成,可以从示例中学习规律。给它展示大量示例,让它从中学习,这个过程叫作训练。这里不用担心内部细节。对于本文,我们只需要知道每种设计如何读取文本。
注意: 模型并不是按完整单词读取文本。它会先把文本切成称为 token 的小片段。一个 token 可以是完整单词、单词的一部分或一个标点符号。为了便于理解,本文会统一说“词”;但每当我们说“词”时,模型实际处理的都是 token。
假设我们给 RNN 一个句子:“The cat sat on the mat.”(猫坐在垫子上。)
RNN 从左到右,一次读取一个词。每读完一个词,它就更新一份很小的记忆,然后继续读下一个词。这份记忆就像一张小纸条。读完“The”后,纸条上会记下一些关于“The”的内容;读完“cat”后,纸条会被改写,用来记住“The cat”;如此继续,直到句末。
最后,整个句子都被压缩进这一张小纸条里。
我们用一张图来理解:
 Word:     The       cat       sat       on        the       mat
            |         |         |         |         |         |
            v         v         v         v         v         v
 Note:   [note] -> [note] -> [note] -> [note] -> [note] -> [note]
                                                              |
                                                              v
                                                   the whole sentence
                                                   lives in this one note
这里只有一张纸条。从一张纸条指向下一张纸条的箭头表示,每读完一个词,同一张纸条就会被改写。过去唯一能传递下去的东西就是这张纸条,没有其他内容。
处理短句时,这种方法还算有效。但问题来了。
问题一:它会遗忘。
假设文本很长,比如一整段话。模型读到末尾时,纸条已经被改写了太多次,开头的词几乎消失了。如果这一段以“Riya went to the market”(Riya 去了市场)开头,以“and then she bought”(然后她买了)结尾,模型就很难记住“she”指的是 Riya。
 Riya  went  to  the  market  and  then  she  bought
  |                                       |
  |   the note is rewritten again and     |
  |   again between these two words       |
  v                                       v
 "Riya" is written into       by now "Riya" has mostly
 the note at the very start   faded out of the note
这里可以看到,“Riya”一开始被写进了纸条,但后面的每个词都会再覆盖一点纸条中的内容。等模型读到“she”时,“Riya”已经所剩无几。
问题二:训练很慢。
模型必须先读第一个词,才能读第二个词;先读第二个词,才能读第三个词。也就是说,它不能同时读取所有词。所以,即使计算机性能很强,可以并行处理数千项任务,RNN 仍然只能一步一步地使用它。
LSTM 和 GRU 是 RNN 的改进版本,大幅缓解了遗忘,却没有彻底消除它;一次只读一个词的缓慢方式也依然存在。
这种方法的问题就是容易遗忘、训练缓慢。下面看看下一种方法如何解决这些问题。
第二阶段:注意力机制
这时,注意力机制(Attention) 登场了。
注意力机制让模型在处理当前词时,可以回看输入中的每一个词,并决定该在每个词上投入多少注意力。
简单来说,我们不再只保留一张小纸条,而是把整页内容都摊开放在面前。需要理解某个词时,就去查看此前哪些词与它有关。
我们用图来看看两者的区别:
 RNN:

   Riya -> went -> to -> the -> market -> and -> then -> she
   (one small note passed along the chain, rewritten at each step)

 Attention:

   Riya   went   to   the   market   and   then   she
    ^      ^      ^    ^      ^       ^      ^     |
    |      |      |    |      |       |      |     |
    +------+------+----+------+-------+------+-----+
             "she" looks directly at every earlier word
在 RNN 中,“she”只能看到沿着链条传到它这里的那张纸条。而在注意力机制中,“she”可以直接连接此前的每一个词,沿途不会丢失任何内容。
注意力机制 = 查看每个词 + 判断每个词的重要程度 + 按重要程度把它们混合起来
还是用刚才的例子:“Riya went to the market and then she bought mangoes.”(Riya 去了市场,然后她买了芒果。)
模型处理“she”时,注意力机制让它查看前面的所有词,并询问:哪些词有助于理解“she”?答案是“Riya”。因此,模型会给“Riya”很高的注意力,而给“to”和“the”等词较低的注意力。
注意力机制如何决定关注哪里
通过示例最容易理解。
假设模型正在处理“she”。为了便于理解,我们只看前面的 4 个词。注意力机制会给每个词一个分数,表示它有多重要,再把这些分数转换成总和为 1 的权重。
- Riya:0.70
- went:0.10
- market:0.15
- then:0.05
可以看到,“Riya”获得了 70% 的注意力。接下来,模型对“she”的理解将主要来自“Riya”,少部分来自“market”,其他词只占很小一部分。
看看模型如何根据这些权重构建对“she”的理解:
   0.70 x Riya    ----+
   0.10 x went    ----+
   0.15 x market  ----+----> understanding of "she"
   0.05 x then    ----+
   ----
   1.00  (the weights add up to 1)
这里,前面的每个词都乘以自己的权重,然后再全部加在一起。因为“Riya”的权重最大,结果也就主要来自“Riya”。
注意力机制就是这么回事:将其他词加权混合,而权重表示每个词有多重要。
这个简单的思想,正是每个现代 LLM 的核心。
查询、键和值
在注意力机制内部,每个词都扮演三种角色。我们用图书馆来打个比方。
- 查询(Query,Q):我们正在提出的问题。处理到“she”时,查询就是“这个人是谁?”
- 键(Key,K):每本书上的标签。前面的每个词都带有一个说明自身内容的标签。“Riya”这个词带有类似“人名”的标签。
- 值(Value,V):书里的内容,也就是这个词实际携带的信息。
模型将查询与每个键进行比较。匹配程度高的键会得到高分。接着,模型根据这些分数对值进行加权收集,得到我们上面看到的加权混合结果。
整个流程如下:
 Query from "she": who is this person?
          |
          v
 Compare the query with every key:
   Key of "Riya"   : a person's name  -> strong match
   Key of "went"   : an action        -> weak match
   Key of "market" : a place          -> weak match
          |
          v
 Collect the values, weighted by the match
          |
          v
 Understanding of "she", built mostly from the value of "Riya"
这里,查询就是问题,键决定哪些词能很好地回答它,值则是我们最终收集的信息。键只用于匹配,实际内容来自值。
我们另有一篇详细介绍 Q、K、V 背后数学原理的文章,通过真实数字逐步解释了这个过程。
自注意力
当一个句子中的词关注同一句子里的其他词时,我们称之为 自注意力(Self-Attention)。也就是这个句子在观察自身。LLM 内部采用的正是这种注意力机制。
多头注意力
一次注意力只能关注一种关系,但一个句子中存在许多关系。“she”和“Riya”在语义上相关,“bought”和“mangoes”在语法上相关,诸如此类。
因此,我们不只运行一次注意力,而是并排运行多次注意力。每一次称为一个头(head)。一个头学习追踪名字,另一个学习追踪语法,还有一个学习追踪位置,等等。最后,我们把所有头发现的内容合并起来。
这就叫作 多头注意力(Multi-Head Attention)。它就像一支阅读团队,每位读者都在同一个句子中寻找不同的东西。
                   The sentence
                        |
         +--------------+--------------+
         |              |              |
         v              v              v
    +----------+   +----------+   +----------+
    |  Head 1  |   |  Head 2  |   |  Head 3  |
    |  tracks  |   |  tracks  |   |  tracks  |
    |  names   |   |  grammar |   | position |
    +----------+   +----------+   +----------+
         |              |              |
         +--------------+--------------+
                        |
                        v
               Combine all the heads
这里,所有头同时读取同一个句子,但每个头寻找的是不同类型的关系。最后,我们把它们各自找到的内容合并成一个结果。
注意力机制解决了遗忘问题,因为输入中的词不再会被挤出记忆。每个词都可以被直接查看。
不过最初,注意力机制只是叠加在 RNN 之上。RNN 仍然一次读取一个词,注意力机制只是帮助模型回看 RNN 已经读过的内容。因此,一次只读一个词的缓慢方式依然存在。
这种方法的问题在于,模型仍然一次只读一个词,速度很慢。下面看看下一种方法如何解决这个问题。
如果想深入学习注意力机制、Q、K、V 矩阵、自注意力和多头注意力,可以查看 Outcome School 的 AI 与机器学习课程。
第三阶段:Transformer
2017 年,一篇题为《Attention Is All You Need》的论文提出了一个大胆的问题:既然真正发挥作用的是注意力机制,为什么还要保留 RNN?
于是,研究人员彻底移除了 RNN,只用注意力机制和几个简单的数学组件构建模型。这个模型就叫作 Transformer。
Transformer 是一种同时读取输入中所有词,并利用注意力机制理解它们之间关系的模型。
Transformer 内部有什么
Transformer 由许多层层堆叠的 block 组成。每个 block 有两个主要部分:
- 多头注意力:词与词彼此查看并收集信息,这是“看”的步骤。
- 前馈网络(Feed-Forward Network):每个词单独经过的一层简单数学运算,用来处理刚才收集到的信息,这是“想”的步骤。
我们会堆叠许多个这样的 block。前面的 block 学习语法等简单规律,更深的 block 学习语义和推理等更复杂的规律。小模型大约有 12 个 block,大模型则有 100 个甚至更多。
这些 block 的堆叠方式如下:
             Input words
                  |
                  v
   +-----------------------------+
   |  Block 1                    |
   |   Multi-Head Attention      |  <- looking step
   |   Feed-Forward Network      |  <- thinking step
   +-----------------------------+
                  |
                  v
   +-----------------------------+
   |  Block 2                    |
   |   Multi-Head Attention      |
   |   Feed-Forward Network      |
   +-----------------------------+
                  |
                  v
                . . .
                  |
                  v
   +-----------------------------+
   |  Block N                    |
   |   Multi-Head Attention      |
   |   Feed-Forward Network      |
   +-----------------------------+
                  |
                  v
        Predict the next word
词从顶部进入,依次通过每个 block,最后一个 block 预测下一个词。每个 block 都执行同样的两个步骤:先看,再想。
词序问题
这里有一个有意思的问题。Transformer 会同时读取所有词,因此它天然不知道哪个词先出现。“Dog bites man”(狗咬人)和“Man bites dog”(人咬狗)在它看来没有区别。
于是,位置编码(Positional Encoding) 派上了用场。在词进入模型之前,我们给每个词添加一个小信号,注明它的位置:第一个词、第二个词、第三个词,依此类推。这样模型就知道顺序了。
最初的 Transformer 使用固定信号。现代 LLM 会用更新的方法完成同一件事,例如 LLaMA 等许多模型采用的 旋转位置嵌入(Rotary Position Embedding,RoPE)。方法发生了变化,思想没有变:告诉模型每个词位于哪里。
编码器、解码器和纯解码器架构
最初的 Transformer 分成两部分。
- 编码器(Encoder):读取并理解输入。
- 解码器(Decoder):参考编码器理解到的内容和自己已经写出的内容,一次一个词地生成输出。
这种架构是为翻译而设计的:读取英语,写出法语。
后来,研究人员发现,生成文本只需要解码器这一半。给它一些词,它会预测下一个词;再把这个词加入输入,继续预测下一个。这就是 纯解码器 Transformer(Decoder-only Transformer),GPT 和今天几乎所有聊天模型采用的都是这种设计。
 Encoder-Decoder (built for translation):

   "The cat sat"  --->  [ Encoder ]  --->  [ Decoder ]  --->  "Le chat s'est assis"

 Decoder-only (used by chat models):

   "The capital of India is"      --->  [ Decoder ]  --->  "New"
   "The capital of India is New"  --->  [ Decoder ]  --->  "Delhi"
这里,纯解码器模型只有一条信息流。它生成的词会被加回输入,然后再次预测。这个循环不断继续,直到回答完成。
这个循环称为自回归生成。我们另有一篇详细介绍自回归模型的文章,解释其工作原理。
Transformer 为什么胜出
Transformer 会并行处理所有词。这与 GPU 完美契合,因为 GPU 这种芯片本来就是为了同时完成数千次小型计算而设计的。用 RNN 需要数周的训练,换成 Transformer 后只需数天。
 RNN (one word per step):

   Step 1    Step 2    Step 3    Step 4    Step 5    Step 6
    The   ->  cat   ->  sat   ->  on    ->  the   ->  mat

 Transformer (all words in one step):

   Step 1
    The     cat     sat     on      the     mat
     |       |       |       |       |       |
     +-------+-------+-------+-------+-------+
                  all processed together
RNN 处理 6 个词需要 6 个步骤,而且每一步都必须等待上一步完成。Transformer 一步就能处理全部 6 个词,所以所有 GPU 核心都能同时保持忙碌。
我们另有一篇详细介绍 RNN 与 Transformer 区别的文章,从头到尾讲解了这项对比。
注意: 这种并行读取适用于输入处理和训练。生成回答时,模型仍像上面的纯解码器循环一样,一次输出一个词。读取可以并行,写出仍要逐词进行。请记住这一点,后面讲到 KV Cache 时还会用到。
这种速度打开了通往下一阶段的大门。既然训练这么快,为什么不用更多数据训练一个更大的模型?
以上就是 Transformer。它解决了训练缓慢的问题。接下来的重大问题是:模型究竟应该做多大?
如果想深入学习 Transformer 架构、位置编码和编码器—解码器架构,并从零构建大语言模型(LLM),可以查看 Outcome School 的 AI 与机器学习课程。
第四阶段:规模扩展
规模扩展(Scaling)是指从三个方面增大模型:更多参数、更多训练数据和更多算力。
下面逐一理解。
- 参数(Parameters):模型的内部设置。可以把模型想成一块有数十亿个小旋钮的巨大面板。训练过程会稍微转动每个旋钮,让预测变得更准确。旋钮的数量就是参数量。
- 数据(Data):模型用于学习的文本,包括书籍、网站、文章、代码等等。
- 算力(Compute):训练期间完成的计算总量。算力更多,意味着用更多 GPU 运行更长时间。
出人意料的发现
大约在 2020 年,研究人员发现了一件出人意料的事:同时增加参数、数据和算力时,模型会以平稳而可预测的方式变得更好,没有突然出现无法突破的高墙。模型越大,效果就持续越好。
这就是所谓的规模定律(Scaling Laws)。它给出了一个公式:投入多少算力,模型大致就能达到怎样的质量。
因此,模型规模迅速增长。
- GPT-2 约有 15 亿个参数。
- 仅仅一年后,GPT-3 就拥有约 1750 亿个参数,规模扩大了 100 多倍。
GPT-3 还能完成 GPT-2 做不到的事情。它可以写文章、回答问题,甚至编写代码,而且并没有针对这些具体任务接受专门训练。这些只在规模增大后才出现的新能力,被称为涌现能力(emergent abilities)。
注意: 一些研究人员认为,这些能力并不是突然出现的。它们会随着规模平稳增长,只是我们的测量方式让它们看起来像突然出现。这个术语仍被广泛使用,因此值得了解。
平衡数据与模型规模
随后出现了一次修正。2022 年,一篇名为 Chinchilla 的研究论文发现,许多大模型训练得并不充分:参数太多,数据却太少。
结论很简单:要获得最佳效果,数据量必须随参数量一起增长。 使用更多数据训练的小模型,可以胜过使用较少数据训练的大模型。因此,LLaMA 等后来的模型会用数万亿个 token 训练。
给你的一点简短建议
无论身处哪个技术领域,都应该熟悉以下主题:
- LLM
- RAG
- MCP
- Agent
- 微调(Fine-tuning)
- 量化(Quantization)
我们把这些内容汇总在一个视频里:
AI 工程详解:LLM、RAG、MCP、Agent、微调与量化
不必停下来观看——先加入书签,有空时再看。未来的你会感谢现在的自己。
现在回到正题。
成本问题
规模扩展奏效了,但也带来了一个新问题。
在普通 Transformer 中,每处理一个词,所有参数都会参与计算。如果一个模型有 1750 亿个参数,而我们向它提出一个包含 100 个词的问题,那么处理这 100 个词中的每一个时,全部 1750 亿个参数都会工作。这种模型称为稠密模型(dense model),因为所有部分始终处于激活状态。
 Dense model:

   word 1    --->  all 175 billion parameters work  --->  output
   word 2    --->  all 175 billion parameters work  --->  output
   word 3    --->  all 175 billion parameters work  --->  output
    ...
   word 100  --->  all 175 billion parameters work  --->  output
无论这个词是简单的“the”,还是复杂的技术术语,整个模型都会处理它。对于简单的词,也没有办法少做一点计算。
所以,模型规模翻倍,每次回答的成本也会翻倍。训练变得非常昂贵,为数百万用户运行模型则更加昂贵。
这种方法的问题是,规模每增加一倍,运行成本也会同样增加。下面看看下一种方法如何解决这个问题。
第五阶段:混合专家模型(MoE)
这时,混合专家模型(Mixture of Experts,MoE) 前来解围。
混合专家模型是一种把模型拆分成许多称为“专家”的较小部分,并且每处理一个词只使用少数几个专家的架构。
我们把它拆开来看。
混合专家模型 = 许多专家 + 一个从中挑选少数专家的路由器
假设我们走进一家大型医院。医院里有心脏、骨科、皮肤和眼科专家。我们进门后,接待人员会听取我们的问题,再把我们送到一两位相关医生那里。不会让四位医生检查每一名患者。
- 医生就是专家(experts)。
- 接待人员就是路由器(router),也叫门控(gate)。
- 每名患者只被送到少数几位医生那里,这叫作稀疏激活(sparse activation)。
MoE 在 Transformer 内部如何工作
还记得每个 Transformer block 内部的前馈网络吗?它就是注意力之后的“思考”步骤。在 MoE 模型中,这一个前馈网络会被许多个前馈网络取代,它们就是专家。专家前面还有一个小型路由器。
对于每个词:
- 路由器查看这个词,并给每个专家打分。
- 它挑选得分最高的少数专家,通常是前 1 个或前 2 个。
- 只有这些专家会处理这个词。
- 它们的输出会被合并,然后向后传递。
注意力部分保持不变,只有“思考”步骤变成了一支专家团队。
我们用图来理解:
             Word comes in
                    |
                    v
 +--------------------------------------+
 |         Multi-Head Attention         |   same as before
 +--------------------------------------+
                    |
                    v
 +--------------------------------------+
 |                Router                |   gives a score to each expert
 +--------------------------------------+
   |    |    |    |    |    |    |    |
  0.4  0.1  0.3  0.0  0.1  0.0  0.1  0.0     scores
   |         |
   v         v
 [E1] [E2] [E3] [E4] [E5] [E6] [E7] [E8]     8 experts
  on   off  on   off  off  off  off  off     only the top 2 work
   |         |
   +----+----+
        |
        v
 Combine the two outputs and pass forward
这里,路由器给专家 1 和专家 3 的分数最高,所以处理这个词时,只有这两个专家工作,另外六个保持空闲。处理下一个词时,路由器可以选择另一对专家。
总参数量与激活参数量
这是核心思想,我们用数字来理解。
假设一开始有一个约 70 亿参数的模型,我们在每个 block 中把原本单一的前馈网络(“思考”步骤)替换成 8 个专家前馈网络。这就是 Mixtral 8x7B 的基本设计。这个名称表示:8 个专家建立在 70 亿参数基础模型的架构上。模型并不会因此变成 8 × 7 = 560 亿参数,因为注意力部分和其他共享组件并没有被复制,只有前馈网络被复制了 8 份。加上共享部分,整个模型总计约有 470 亿个参数。
注意: 为了便于理解,这里的数字经过了取整。
处理每个词时,路由器只会从 8 个专家中选 2 个。因此,每处理一个词,实际参与运算的约有 130 亿个参数。
- 总参数量:约 470 亿。这是模型拥有的知识量。
- 激活参数量:约 130 亿。这是处理每个词时完成的工作量。
 Total parameters (what the model knows):

   [ shared parts ] [E1] [E2] [E3] [E4] [E5] [E6] [E7] [E8]   = about 47 billion

 Active parameters (what works for one word):

   [ shared parts ] [E1]      [E3]                            = about 13 billion
8 个专家全都存在于模型内部,但处理任意一个词时,只有 2 个专家会与共享部分一起启动。
也就是说,模型拥有 470 亿参数模型的知识,运行成本却接近 130 亿参数模型。两者并不完全相等,因为路由器和共享部分也会完成一些工作,但这仍比运行全部 470 亿参数便宜得多。这正是 MoE 的精妙之处。
这样一来,我们便可以用 MoE 解决成本问题,同时不必牺牲知识容量。
DeepSeek-V3 等更大的模型把这个思路推进得更远。它的总参数量约为 6710 亿,但处理每个词时只会激活约 370 亿个参数。
每个专家会学到什么
还有一点值得注意:我们并不会告诉专家应该专攻什么。训练过程中,路由器与专家一起学习。最终,有些专家负责标点,有些负责数字,有些负责部分代码,还有一些负责特定类型的词。这种分工并不总是泾渭分明,却会自行形成。
MoE 的问题
MoE 并非没有代价,它也有自己的问题。
- 内存:虽然每个词只由 2 个专家处理,但 8 个专家都必须加载进内存,因为下一个词可能会被送到另一对专家那里。因此,MoE 节省的是计算量,而不是内存。
- 负载均衡:如果路由器总把所有内容送给同两个专家,其他专家就永远学不到东西。因此,训练时需要增加一条额外的小规则,推动路由器分散工作量。没有它,MoE 就会失败。
- 训练复杂度:路由决策会降低训练的稳定性,也更难把训练做对。
尽管如此,正是因为有了 MoE,我们才能让拥有数千亿参数的模型在合理时间内给出回答。如今,大多数规模最大的模型都会以某种形式采用 MoE。
以上就是混合专家模型。它解决了“思考”步骤的成本问题,但注意力步骤本身也有成本,这就把我们带到了当前正在发生的变化。
Outcome School 有一套完整课程,涵盖混合专家模型(MoE)、优化与规模扩展技术以及 LLM 内部原理,可以查看我们的 AI 与机器学习课程。
第六阶段:新方向
研究人员如今正在同时探索几个方向。下面看看其中重要的方向。
长上下文问题
我们一次提供给模型的文本称为上下文(context)。今天,我们想把整本书、长对话和大型代码库交给模型,这就产生了一个问题。
注意力机制会把每个词与其他每个词进行比较。如果输入有 1000 个词,就要进行 1000 × 1000 = 100 万次比较;如果输入有 10 万个词,就要进行 100 亿次比较。输入长度翻倍,比较成本就会变成四倍。
 4 words  ->  4 x 4 = 16 comparisons

          The   cat   sat   on
   The     x     x     x     x
   cat     x     x     x     x
   sat     x     x     x     x
   on      x     x     x     x

 8 words  ->  8 x 8 = 64 comparisons   (2 times the words, 4 times the cost)
这里,每一行代表一个词查看每一列。增加一个词,就会增加完整的一行和一列,所以网格的增长速度远快于输入。
此外,模型生成回答时,会存储此前每个词的键和值,以免重新计算。这种存储称为 KV Cache。面对长输入,KV Cache 会变得极其庞大,占用大量内存。
为了解决这个问题,人们提出了几种设计:
- 分组查询注意力(Grouped Query Attention,GQA):多个注意力头共享同一组键和值,而不是每个头都拥有自己的键和值。这样可以大幅缩小 KV Cache,质量损失却很小。LLaMA 3 等许多模型都采用了这种方法。
- 多头潜在注意力(Multi-Head Latent Attention,MLA):先把键和值压缩成较小的形式再存储,需要时再展开。DeepSeek 模型采用了这种方法。
- 滑动窗口注意力(Sliding Window Attention):每个词只查看固定窗口内的邻近词,而不是查看所有词。信息仍然可以通过多个 block 的传递抵达远处。Mistral 采用了这种方法。
下面分别用图来看。先看 GQA:
 Multi-Head Attention:                Grouped Query Attention:

   Head 1 -> own Key + Value            Head 1 --+
   Head 2 -> own Key + Value            Head 2 --+--> shared Key + Value (group A)
   Head 3 -> own Key + Value            Head 3 --+
   Head 4 -> own Key + Value            Head 4 --+

   Head 5 -> own Key + Value            Head 5 --+
   Head 6 -> own Key + Value            Head 6 --+--> shared Key + Value (group B)
   Head 7 -> own Key + Value            Head 7 --+
   Head 8 -> own Key + Value            Head 8 --+

   8 sets stored in the KV Cache        2 sets stored in the KV Cache
这里,注意力头会被分组,同一组里的所有头共享一套键和值。8 个头分成 2 组后,KV Cache 会缩小到原来的四分之一。每个头仍会提出自己的查询,因此质量几乎不变。
接下来看 MLA:
 Normal attention:

   Key + Value (big)  ------------------------------->  stored in KV Cache (big)

 Multi-Head Latent Attention:

   Key + Value (big)  --> compress -->  small form  -->  stored in KV Cache (small)
                                             |
                                             v
                          expand back to full size only when needed
MLA 不会存储庞大的键和值,而是存储一份较小的压缩形式。模型需要时,再把压缩形式展开。因此,KV Cache 存储的内容少得多,模型回看时仍能获得完整信息。
最后来看滑动窗口注意力:
 Full attention:

   w1   w2   w3   w4   w5   w6   w7   w8
    ^    ^    ^    ^    ^    ^    ^    |
    +----+----+----+----+----+----+----+
          w8 looks at all 7 earlier words

 Sliding Window Attention (window = 3):

   w1   w2   w3   w4   w5   w6   w7   w8
                        ^    ^    ^    |
                        +----+----+----+
          w8 looks only at the 3 nearest words

 How information still travels far:

   Block 1:  w5 gathers from w2, w3, w4
   Block 2:  w8 gathers from w5, w6, w7, and w5 already carries w2, w3, w4
在 Block 1 中,w5 已经从 w2、w3 和 w4 收集了信息。在 Block 2 中,w8 查看 w5 时,也会间接获得这些信息。因此,即使窗口很小,远处的信息仍能逐个 block 传递过来。
凭借这些方法,模型一次能读取的内容从大约 2000 个 token 增长到了 100 万个 token。
一种新的记忆:状态空间模型
一些研究人员重新采用了一次读取一个词的思路,但配上了聪明得多的记忆。这类模型称为状态空间模型(State Space Models),其中较为流行的是 Mamba。
简单来说,Mamba 像 RNN 一样维护持续更新的记忆,因此其成本会随输入长度线性增长,而不是平方增长。但与旧式 RNN 不同,Mamba 会查看每个新到来的词,决定哪些内容应该保留在记忆中,哪些应该丢弃。因此,远处的重要信息会比在旧式 RNN 中保留得更好。
下面粗略展示成本的增长方式。数字仅用于比较,并非真实测量结果:
 Input length:      1,000     2,000     4,000     8,000  words

 Attention cost:    1 unit    4 units   16 units  64 units   (squares)
 Mamba cost:        1 unit    2 units   4 units   8 units    (straight line)
每当输入长度翻倍,注意力机制的成本都会变成四倍,而 Mamba 的成本只会变成两倍。面对很长的输入,这种差距会变得非常大。
如今,我们也能看到 混合架构(hybrid) 模型:把少量注意力 block 与大量 Mamba block 结合起来,力求同时获得注意力机制的准确性与 Mamba 的速度。
用同一个模型处理文本、图像和音频
早期 LLM 只能读取文本。现在,同一种 Transformer 设计也被用于图像、音频和视频。图像会被切分成许多小块,每个图像块都像单词一样变成一个 token,再由同一种注意力机制处理。音频和视频的处理方式与之类似。这类模型称为 多模态 模型。
不扩大模型,而是延长思考时间
多年以来,获得更聪明模型的方法就是把模型做得更大。现在有了第二种方法:让模型在回答之前思考得更久。
推理模型在给出最终答案之前,会生成一条很长的思考步骤链。在这些步骤中,它们常常会尝试不同路径,并检查自己的工作。这叫作在 推理时(inference time) 进行规模扩展。“推理”指的就是模型回答问题的阶段。也就是说,我们不只在训练时投入更多算力,也在回答时投入更多算力。
因此,规模扩展如今有了两个方向:扩展训练规模,以及扩展思考规模。
演进历程总结
下面用一张图展示完整历程:
 RNN  --->  Attention  --->  Transformer  --->  Scaling  --->  MoE  --->  New Directions

 forgets    fixes            removes the        makes the      cuts the   long context,
 and slow   forgetting       slow RNN           model smart    cost       Mamba, reasoning
这里,每个箭头都代表一个问题得到了解决。每个阶段都会保留上一阶段行之有效的部分,并修复其中最严重的问题。
为了便于理解,我们把完整历程列成表格。
| 阶段 | 核心思想 | 解决的问题 | 遗留的问题 |
|---|---|---|---|
| RNN | 用一份记忆,一次读取一个词 | 可以读取任意长度的文本 | 忘记开头的词,训练缓慢 |
| 注意力机制 | 通过权重查看前面的每个词 | 遗忘 | 底层仍使用 RNN,所以依然缓慢 |
| Transformer | 只用注意力机制,并行处理所有词 | 训练缓慢 | 模型应该做多大 |
| 规模扩展 | 增加参数、数据和算力 | 模型质量 | 成本随规模增长 |
| 混合专家模型 | 每个词只使用少数专家 | 大模型的运行成本 | 内存、负载均衡 |
| 新方向 | GQA、MLA、Mamba、多模态、推理 | 长上下文、新输入类型、更聪明的回答 | 仍在演进 |
这里的规律很清楚:每个阶段都保留上一阶段的优点,同时修复其中最严重的问题。
- 注意力机制保留了读取文本的思路,并解决了遗忘问题。
- Transformer 保留了注意力机制,并移除了拖慢速度的部分。
- 规模扩展保留了 Transformer,并把它做得更大。
- MoE 保留了模型规模,同时降低成本。
- 更新的思路保留了这一切,并继续向前推进,为我们带来更长的上下文、新的输入类型和更聪明的回答。
至此,我们应该已经理解了 LLM 架构从注意力机制到规模扩展,再到混合专家模型及后续方向的演进。下次听说一个新模型时,我们可以问一个简单的问题:它试图解决这条时间线上的哪个问题?
为 AI 工程面试做好准备:AI 工程面试题
这次就到这里。
谢谢。
Amit Shekhar, Outcome School 创始人