Aleksa Gordić
2025-08-29
D
原文
---
title: "深入 vLLM:高吞吐 LLM 推理系统剖析"
author: "Aleksa Gordić"
source_url: "https://www.aleksagordic.com/blog/vllm"
published_at: "2025-08-29"
fetched_at: "2026-09-11T15:31:47Z"
updated_at: "2026-09-11T15:38:20Z"
language: "zh"
review_status: "draft"
---
# 深入 vLLM:高吞吐 LLM 推理系统剖析
## 从 paged attention、continuous batching、prefix caching、specdec 等机制,到多 GPU、多节点的大规模动态服务
2025 年 8 月 29 日
在这篇文章里,我会逐步介绍一个现代高吞吐 LLM 推理系统的所有核心系统组件和高级特性。具体来说,我会拆解 vLLM [[1]](#ref-1) 是如何工作的。
这是这个系列的第一篇。它会先从宏观开始,再逐层加入细节(采用倒金字塔式的方法),让你能够建立一个准确的高层系统心智模型,而不是一开始就淹没在细枝末节里。
后续文章会深入具体子系统。
本文分为五个部分:
1. [LLM engine & engine core](#cpt1):vLLM 的基础(调度、paged attention、continuous batching 等)
2. [高级特性](#cpt2):chunked prefill、prefix caching、guided decoding、speculative decoding、disaggregated P/D
3. [纵向扩展](#cpt3):从单 GPU 到多 GPU 执行
4. [服务层](#cpt4):分布式 / 并发的 Web 脚手架
5. [Benchmark 与自动调参](#cpt5):衡量延迟和吞吐
📝说明
- 分析基于 [commit 42172ad](https://github.com/vllm-project/vllm/tree/42172ad)(2025 年 8 月 9 日)。
- 目标读者:任何好奇前沿 LLM engine 如何工作的人,以及有兴趣为 vLLM、SGLang 等项目贡献代码的人。
- 我会重点关注 [V1 engine](https://docs.vllm.ai/en/latest/usage/v1_guide.html)。我也研究过 V0([现在已经废弃](https://github.com/vllm-project/vllm/issues/18571)),这对理解项目如何演进很有价值,而且许多概念仍然沿用下来。
- 第一节关于 LLM Engine / Engine Core 的内容可能会有点信息量大、偏干,但后面的博客会有很多例子和图。:)
## LLM Engine & Engine Core
LLM engine 是 vLLM 的基础构件。单独看它,已经可以实现高吞吐推理,但只限于离线场景。你还不能把它作为 Web 服务提供给客户。
我们会用下面这段离线推理代码作为贯穿全文的例子(改编自 [basic.py](https://github.com/vllm-project/vllm/blob/main/examples/offline_inference/basic/basic.py))。
```
from vllm import LLM, SamplingParams
prompts = [
"Hello, my name is",
"The president of the United States is",
]
sampling_params = SamplingParams(temperature=0.8, top_p=0.95)
def main():
llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")
outputs = llm.generate(prompts, sampling_params)
if __name__ == "__main__":
main()
```
📝环境变量:
- VLLM\_USE\_V1="1" # we're using engine V1
- VLLM\_ENABLE\_V1\_MULTIPROCESSING="0" # we're running in a single process
这个配置是:
- 离线的(没有 Web / 分布式系统脚手架)
- 同步的(所有执行都发生在一个阻塞式单进程里)
- 单 GPU 的(没有数据 / 模型 / 流水线 / 专家并行;DP/TP/PP/EP = 1)
- 使用标准 transformer [[2]](#ref-2)(支持 Jamba 这类混合模型需要更复杂的混合 KV-cache 内存分配器)
从这里开始,我们会逐步搭到一个在线、异步、多 GPU、多节点的推理系统,但仍然服务的是标准 transformer。
在这个例子里,我们做了两件事:
1. 实例化一个 engine
2. 在它上面调用 `generate`,从给定 prompt 里采样
我们先从构造函数开始分析。
## LLM Engine 构造函数
engine 的主要组件包括:
- vLLM config(包含配置模型、cache、并行等所有旋钮)
- processor(通过校验、tokenization 和处理,把原始输入转成 `EngineCoreRequests`)
- engine core client(在我们的贯穿示例里使用的是 `InprocClient`,基本上等同于 `EngineCore`;后面会逐步搭到支持大规模服务的 `DPLBAsyncMPClient`)
- output processor(把原始 `EngineCoreOutputs` 转成用户看到的 `RequestOutput`)
📝说明:
随着 V0 engine 被废弃,类名和细节可能会变化。我会强调核心思想,而不是精确签名。我会抽象掉一部分细节,但不会全部抽象掉。
Engine core 本身由几个子组件组成:
- Model Executor(驱动模型的 forward pass;我们现在处理的是 `UniProcExecutor`,它在单个 GPU 上只有一个 `Worker` 进程)。后面会逐步搭到支持多 GPU 的 `MultiProcExecutor`
- Structured Output Manager(用于 guided decoding,后面会讲)
- Scheduler(决定哪些请求进入下一次 engine step),它进一步包含:
1. policy 设置,可以是 **FCFS**(first come first served,先到先服务),也可以是 **priority**(高优先级请求先服务)
2. `waiting` 和 `running` 队列
3. KV cache manager,也就是 paged attention [[3]](#ref-3) 的核心
KV-cache manager 维护一个 `free_block_queue`,也就是可用 KV-cache block 的池子(通常有几十万块,取决于 VRAM 大小和 block size)。在 paged attention 中,这些 block 充当索引结构,把 token 映射到它们已经计算好的 KV cache block。
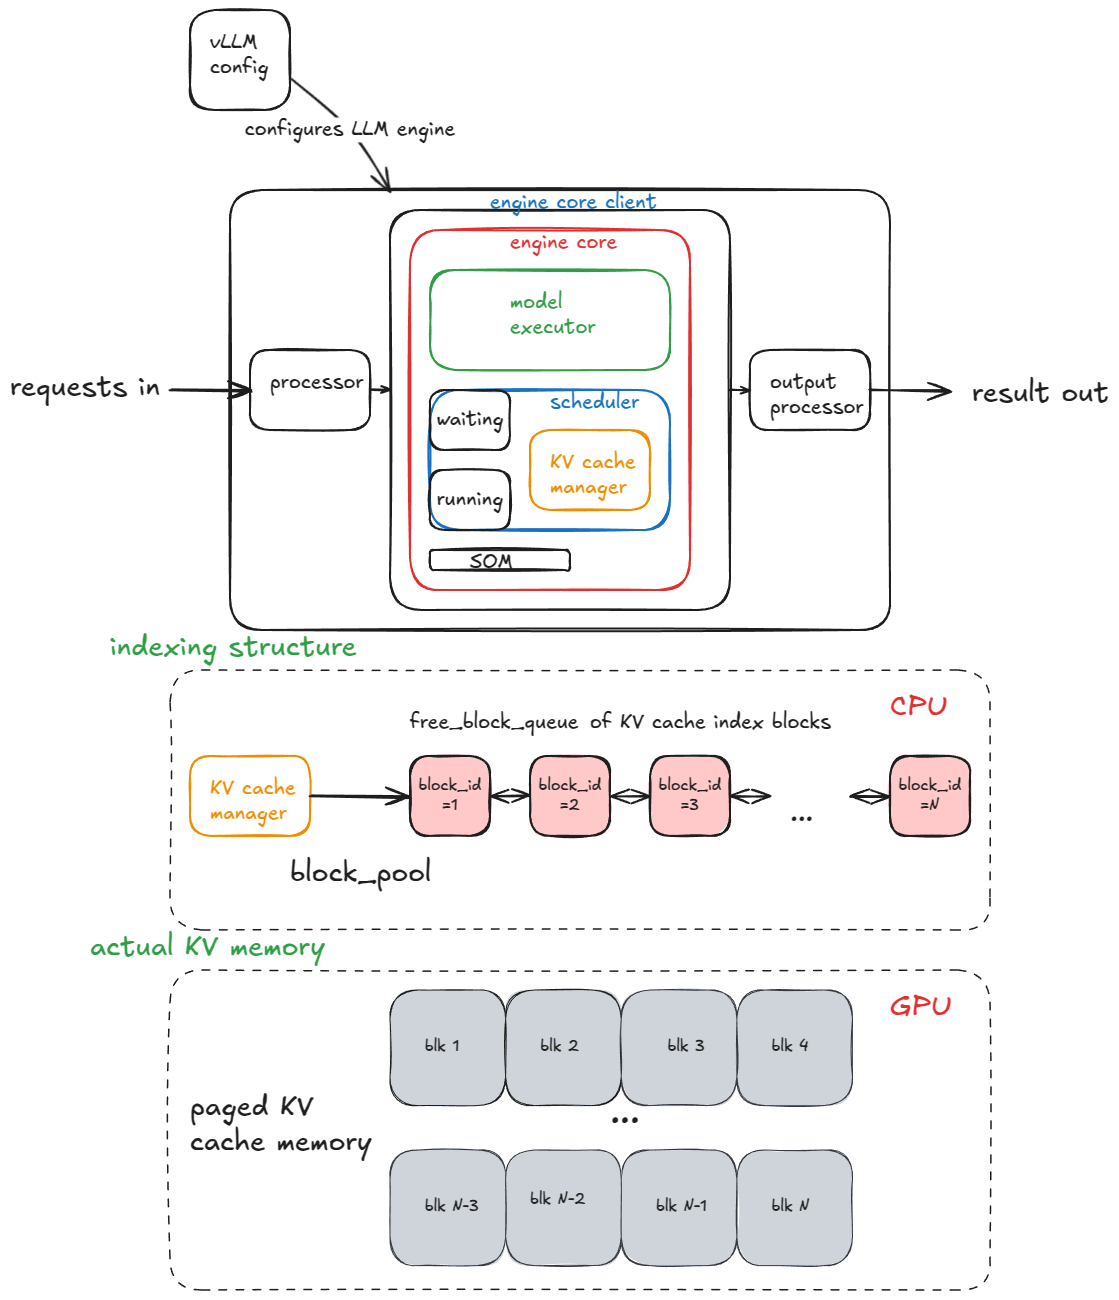
本节描述的核心组件及其关系
标准 transformer 层(非 MLA [[4]](#ref-4))的 block 大小按下面的方式计算:
2 (key/value) \* `block_size` (default=16) \* `num_kv_heads` \* `head_size` \* `dtype_num_bytes` (e.g. 2 for bf16)
在构造 model executor 时,会创建一个 `Worker` 对象,并执行三个关键过程。(后面到了 `MultiProcExecutor`,这些同样的过程会在不同 GPU 上的每个 worker 进程里独立运行。)
1. 初始化设备:
- 给 worker 分配一个 CUDA 设备(例如 "cuda:0"),并检查模型 dtype 是否受支持(例如 bf16)
- 根据请求的 `gpu_memory_utilization`(例如 0.8 → 总 VRAM 的 80%),确认有足够的 VRAM 可用
- 设置分布式配置(DP / TP / PP / EP 等)
- 实例化一个 `model_runner`(持有 sampler、KV cache,以及 `input_ids`、`positions` 等 forward-pass buffer)
- 实例化一个 `InputBatch` 对象(持有 CPU 侧的 forward-pass buffer、用于 KV-cache 索引的 block table、sampling metadata 等)
2. 加载模型:
- 实例化模型架构
- 加载模型权重
- 调用 model.eval()(PyTorch 的推理模式)
- 可选:对模型调用 torch.compile()
3. 初始化 KV cache
- 获取每层的 KV-cache spec。历史上它一直是 `FullAttentionSpec`(同质 transformer),但有了混合模型(sliding window、Jamba 这样的 Transformer/SSM)之后就变得更复杂了(参见 Jenga [[5]](#ref-5))
- 运行一次 dummy / profiling forward pass,并做一次 GPU 内存快照,用来计算可用 VRAM 里能放下多少 KV cache block
- 分配、reshape 并把 KV cache tensor 绑定到 attention layer
- 准备 attention metadata(例如把 backend 设置为 FlashAttention),后续在 fwd pass 中会被 kernel 使用
- 除非提供了 `--enforce-eager`,否则会针对每个 warmup batch size 做一次 dummy run 并捕获 CUDA graph。CUDA graph 会把整串 GPU 工作记录成一个 DAG。后续 fwd pass 中,我们启动 / 重放这些预先烘焙好的 graph,减少 kernel launch 开销,从而改善延迟。
这里我抽象掉了很多低层细节,但这些是我现在要介绍的核心部分,因为后面几节会反复引用它们。
现在 engine 已经初始化好了,我们继续看 `generate` 函数。
## Generate 函数
第一步是校验请求,并把请求送进 engine。对每个 prompt,我们会:
1. 创建一个唯一 request ID,并记录它的到达时间
2. 调用输入预处理器,对 prompt 做 tokenization,并返回一个字典,里面包含 `prompt`、`prompt_token_ids` 和 `type`(text、tokens、embeds 等)
3. 把这些信息打包进 `EngineCoreRequest`,同时加入 priority、sampling params 和其他 metadata
4. 把请求传给 engine core,后者把它包成一个 `Request` 对象,并把状态设为 `WAITING`。然后这个请求会被加入 scheduler 的 `waiting` 队列(如果是 FCFS,就 append;如果是 priority,就 heap-push)
到这里,engine 已经吃到了请求,可以开始执行了。在同步 engine 的例子里,这些初始 prompt 就是我们会处理的全部内容,没有机制能在运行中途注入新请求。相比之下,异步 engine 支持这一点(也就是 **continuous batching** [[6]](#ref-6)):每一步之后,新请求和旧请求都会一起被考虑。
因为 forward pass 会把 batch flatten 成一个单一序列,并由自定义 kernel 高效处理,所以即便在同步 engine 里,continuous batching 从根上也是受支持的。
接下来,只要还有请求需要处理,engine 就会反复调用它的 `step()` 函数。每一步有三个阶段:
1. 调度:选择这一步要运行哪些请求(decode,和 / 或(chunked)prefill)
2. Forward pass:运行模型并采样 token
3. 后处理:把采样出的 token ID 追加到每个 `Request`,detokenize,并检查停止条件。如果某个请求完成,就做清理(例如把它的 KV-cache block 还给 `free_block_queue`),并提前返回输出
📝停止条件包括:
- 请求超过了长度限制(`max_model_length` 或请求自己的 `max_tokens`)
- 采样出的 token 是 EOS ID(除非启用了 `ignore_eos`;这在 benchmark 中很有用,因为我们想强制生成某个数量的输出 token)
- 采样出的 token 匹配 sampling 参数里指定的任意 `stop_token_ids`
- 输出里出现 stop string:我们会把输出截断到第一个 stop string 出现的位置,并在 engine 里终止该请求(注意,`stop_token_ids` 会出现在输出里,但 stop string 不会)。
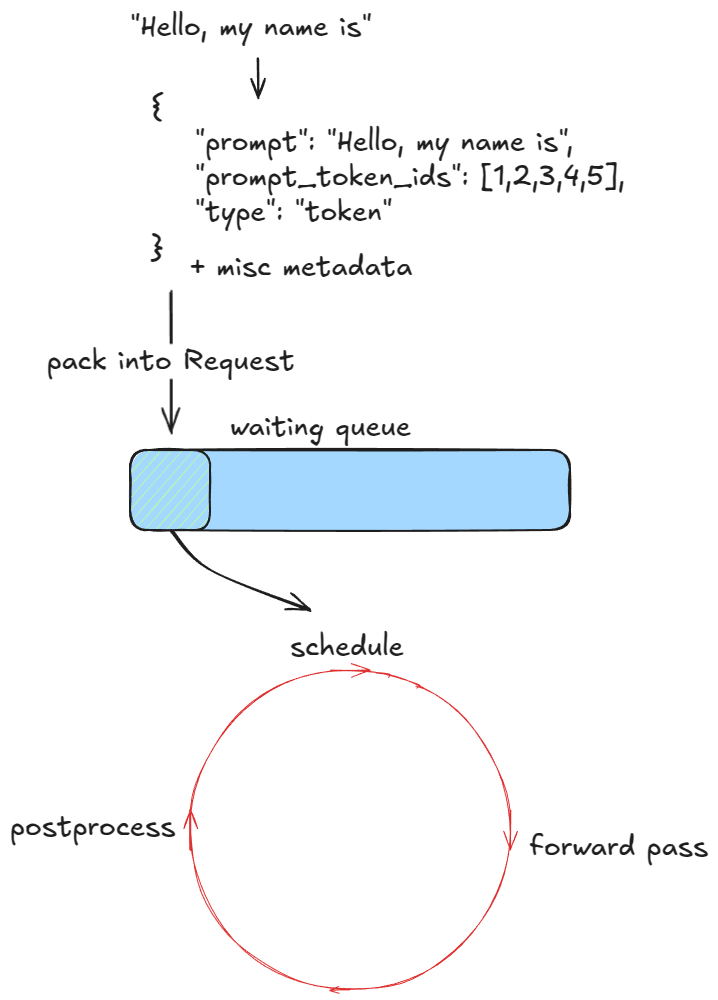
Engine loop
在 streaming 模式下,我们会在中间 token 生成时就发送出去,但现在先忽略这一点。
接下来,我们更详细地看调度。
## Scheduler
推理 engine 处理的工作负载主要有两类:
1. **Prefill** 请求:对所有 prompt token 做一次 forward pass。它们通常是 **compute-bound**(阈值取决于硬件和 prompt 长度)。最后,我们会从最后一个 token 位置的概率分布中采样一个 token。
2. **Decode** 请求:只对最近的一个 token 做 forward pass。更早的 KV vector 已经缓存好了。它们是 **memory-bandwidth-bound**,因为即使只计算一个 token,我们仍然需要加载全部 LLM 权重(以及 KV cache)。
在 [benchmark 章节](#cpt5)里,我们会分析所谓的 GPU 性能 roofline model。那里会更详细地解释 prefill / decode 的性能画像。
V1 scheduler 得益于更聪明的设计选择,可以在同一步里混合两类请求。相比之下,V0 engine 一次只能处理 prefill 或 decode 其中一种。
scheduler 会优先处理 decode 请求,也就是已经在 `running` 队列里的请求。对每个这类请求,它会:
1. 计算要生成的新 token 数(不总是 1,因为有 speculative decoding 和 async scheduling,后面会讲)。
2. 调用 KV-cache manager 的 `allocate_slots` 函数(细节见下文)。
3. 从 token budget 中减去第 1 步的 token 数。
之后,它会处理 `waiting` 队列里的 prefill 请求:
1. 取回已经计算好的 block 数(如果 prefix caching 被禁用,则返回 0;后面会讲)。
2. 调用 KV-cache manager 的 `allocate_slots` 函数。
3. 从 waiting 中弹出请求,把它移到 running,并把状态设为 `RUNNING`。
4. 更新 token budget。
现在来看 `allocate_slots` 做了什么:
1. **计算 block 数**:判断必须分配多少个新的 KV-cache block(`n`)。默认每个 block 存 16 个 token。例如,如果一个 prefill 请求有 17 个新 token,就需要 `ceil(17/16) = 2` 个 block。
2. **检查可用性**:如果 manager 的池子里没有足够 block,就提前退出。根据这是 decode 还是 prefill 请求,engine 可能尝试 recompute preemption(V0 支持 swap preemption):逐出低优先级请求(调用 `kv_cache_manager.free`,把 KV block 还给 block pool),或者跳过本次调度并继续执行。
3. **分配 block**:通过 KV-cache manager 的 coordinator,从 block pool 里取出前 `n` 个 block(也就是前面提到的 `free_block_queue` 双向链表)。把它们存到 `req_to_blocks`,这个字典把每个 `request_id` 映射到它的 KV-cache block 列表。
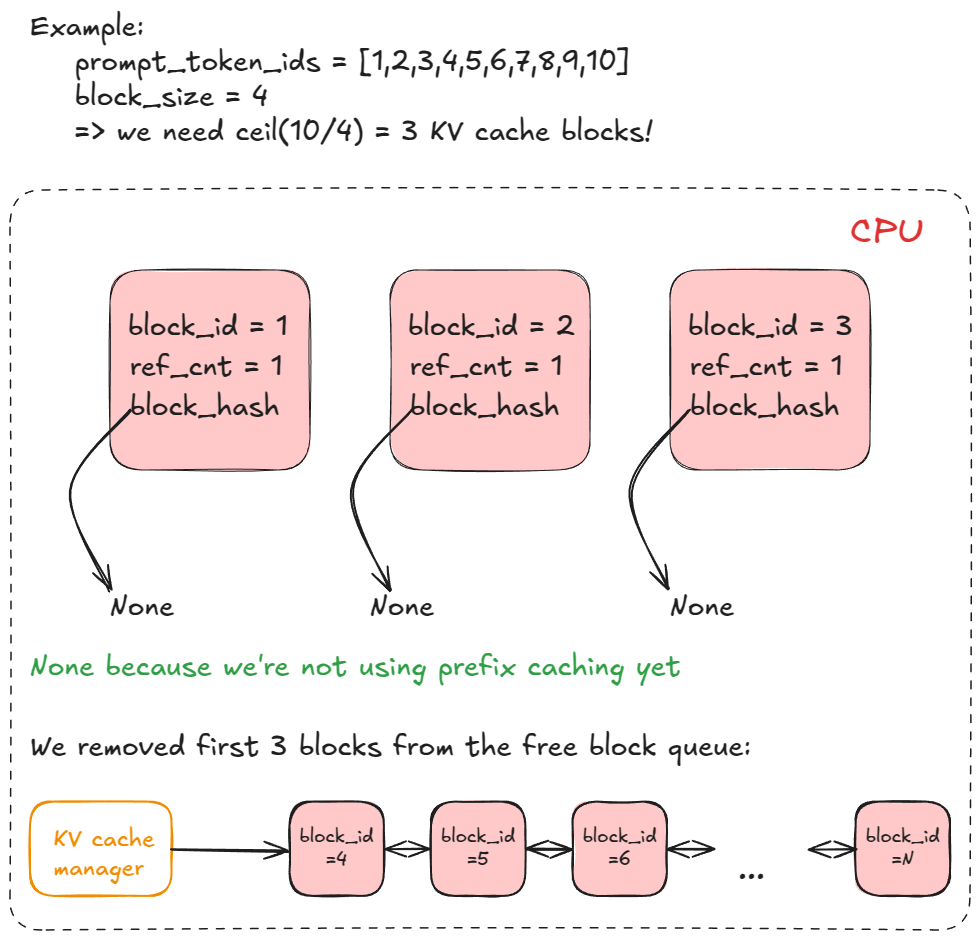
KV cache block 列表
我们终于准备好做 forward pass 了!
## 运行 forward pass
我们调用 model executor 的 `execute_model`,它会委托给 `Worker`,而 Worker 又会委托给 model runner。
主要步骤如下:
1. **更新状态**:从 `input_batch` 中裁掉已经完成的请求;更新与 fwd pass 相关的各种 metadata(例如每个请求对应的 KV cache block,后面会用它们索引 paged KV cache memory)。
2. **准备输入**:把 buffer 从 CPU 拷到 GPU;计算 position;构建 `slot_mapping`(例子里会展开);构造 attention metadata。
3. **Forward pass**:用自定义 paged attn kernel 运行模型。所有序列都会被 flatten 并拼接成一个长长的“super sequence”。Position index 和 attention mask 会确保每个序列只 attend 自己的 token,从而不需要 right-padding 就能实现 continuous batching。
4. **收集 last-token state**:提取每个序列最后一个位置的 hidden state,并计算 logits。
5. **采样**:根据 sampling config(greedy、temperature、top-p、top-k 等)从算出的 logits 中采样 token。
Forward-pass step 本身有两种执行模式:
1. **Eager mode**:启用 eager execution 时,运行标准 PyTorch forward pass。
2. **“Captured” mode**:如果没有强制 eager,就执行 / 重放一个预先捕获的 CUDA Graph(记得我们是在 engine 构造阶段的 initialize KV cache 过程中捕获它们的)。
下面这个具体例子应该能让 continuous batching 和 paged attention 变清楚:
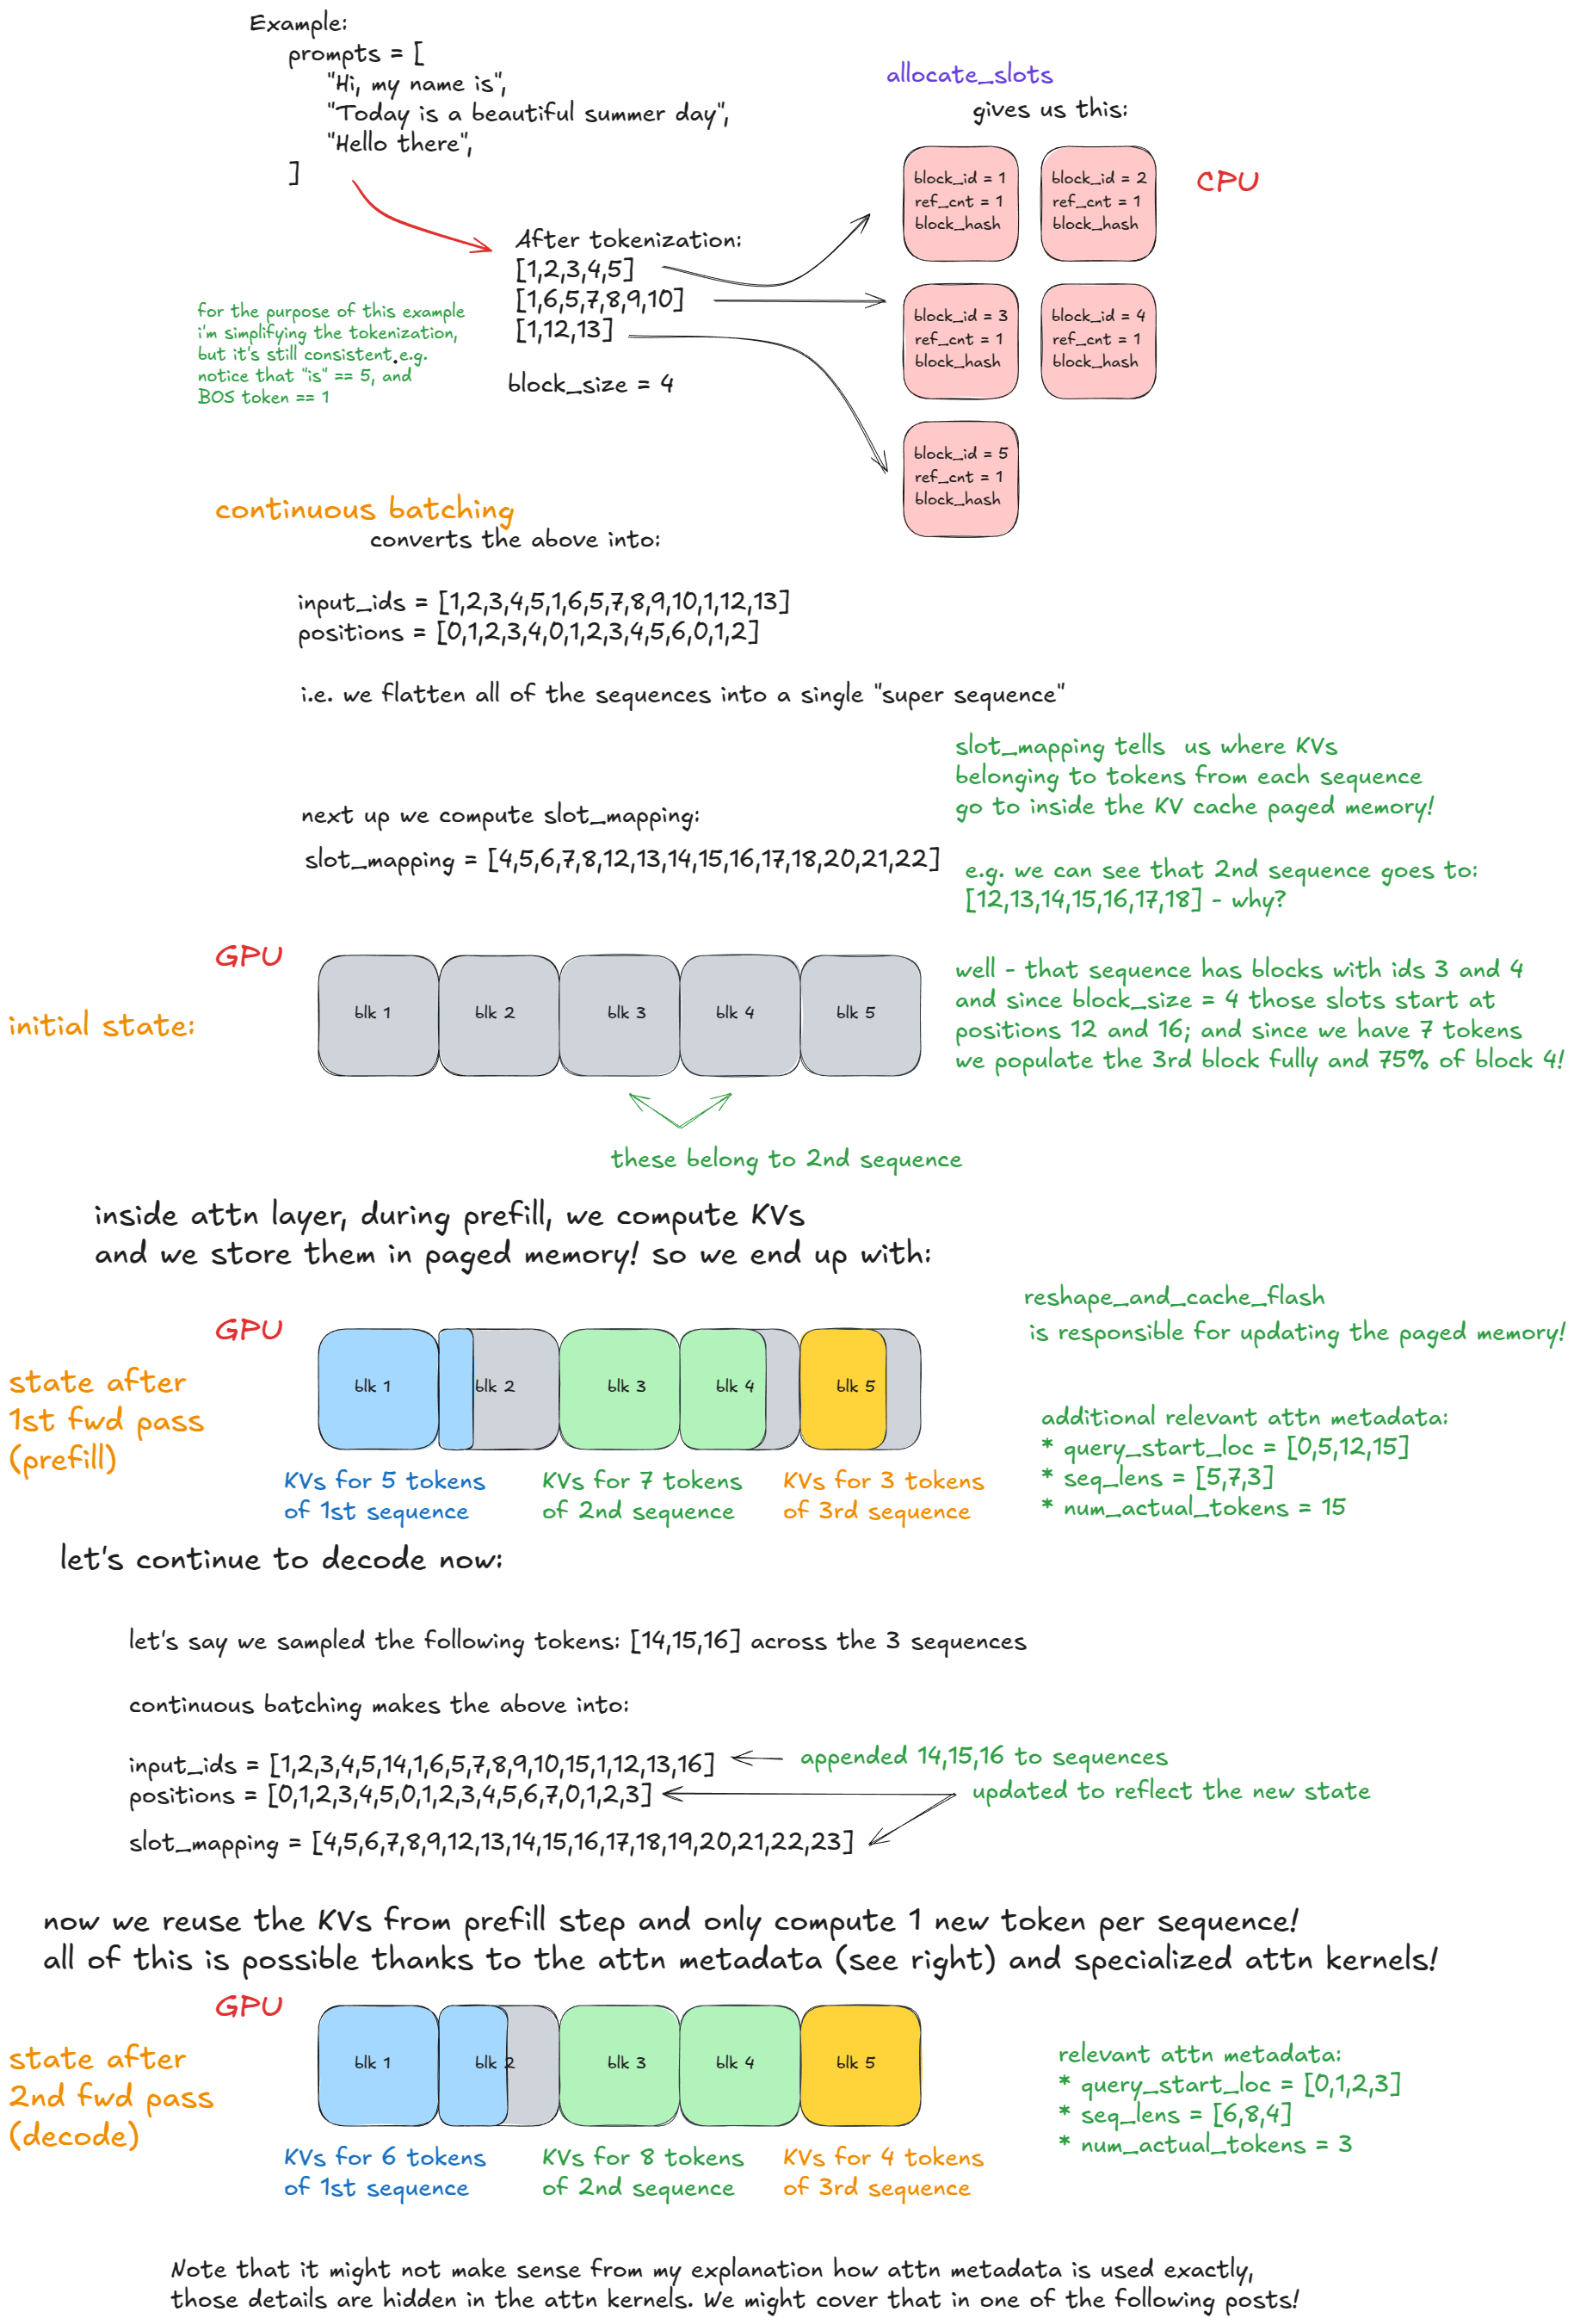
Forward pass:continuous batching 和 paged attention
## 高级特性:扩展核心 engine 逻辑
有了基本 engine 流程之后,我们现在可以看看高级特性。
我们已经讨论过 preemption、paged attention 和 continuous batching。
接下来,我们会深入:
1. Chunked prefill
2. Prefix caching
3. Guided decoding(通过 grammar-constrained finite-state machines)
4. Speculative decoding
5. Disaggregated P/D(prefill/decoding)
## Chunked prefill
Chunked prefill 是一种处理长 prompt 的技术:它把 prefill step 拆成更小的 chunk。没有它时,一个非常长的请求可能会独占一次 engine step,使其他 prefill 请求无法运行。这会推迟所有其他请求,增加它们的延迟。
举个例子,假设每个 chunk 包含 `n`(=8)个 token,用小写字母标记,并用 “-” 分隔。一个长 prompt `P` 可能长成 `x-y-z`,其中 `z` 是一个不完整 chunk(例如 2 个 token)。那么执行 `P` 的完整 prefill 至少需要 3 个 engine step(如果某一步没有被调度执行,还可能更多),并且只有在最后一次 chunked prefill step 中,我们才会采样一个新 token。
下面是同一个例子的图示:
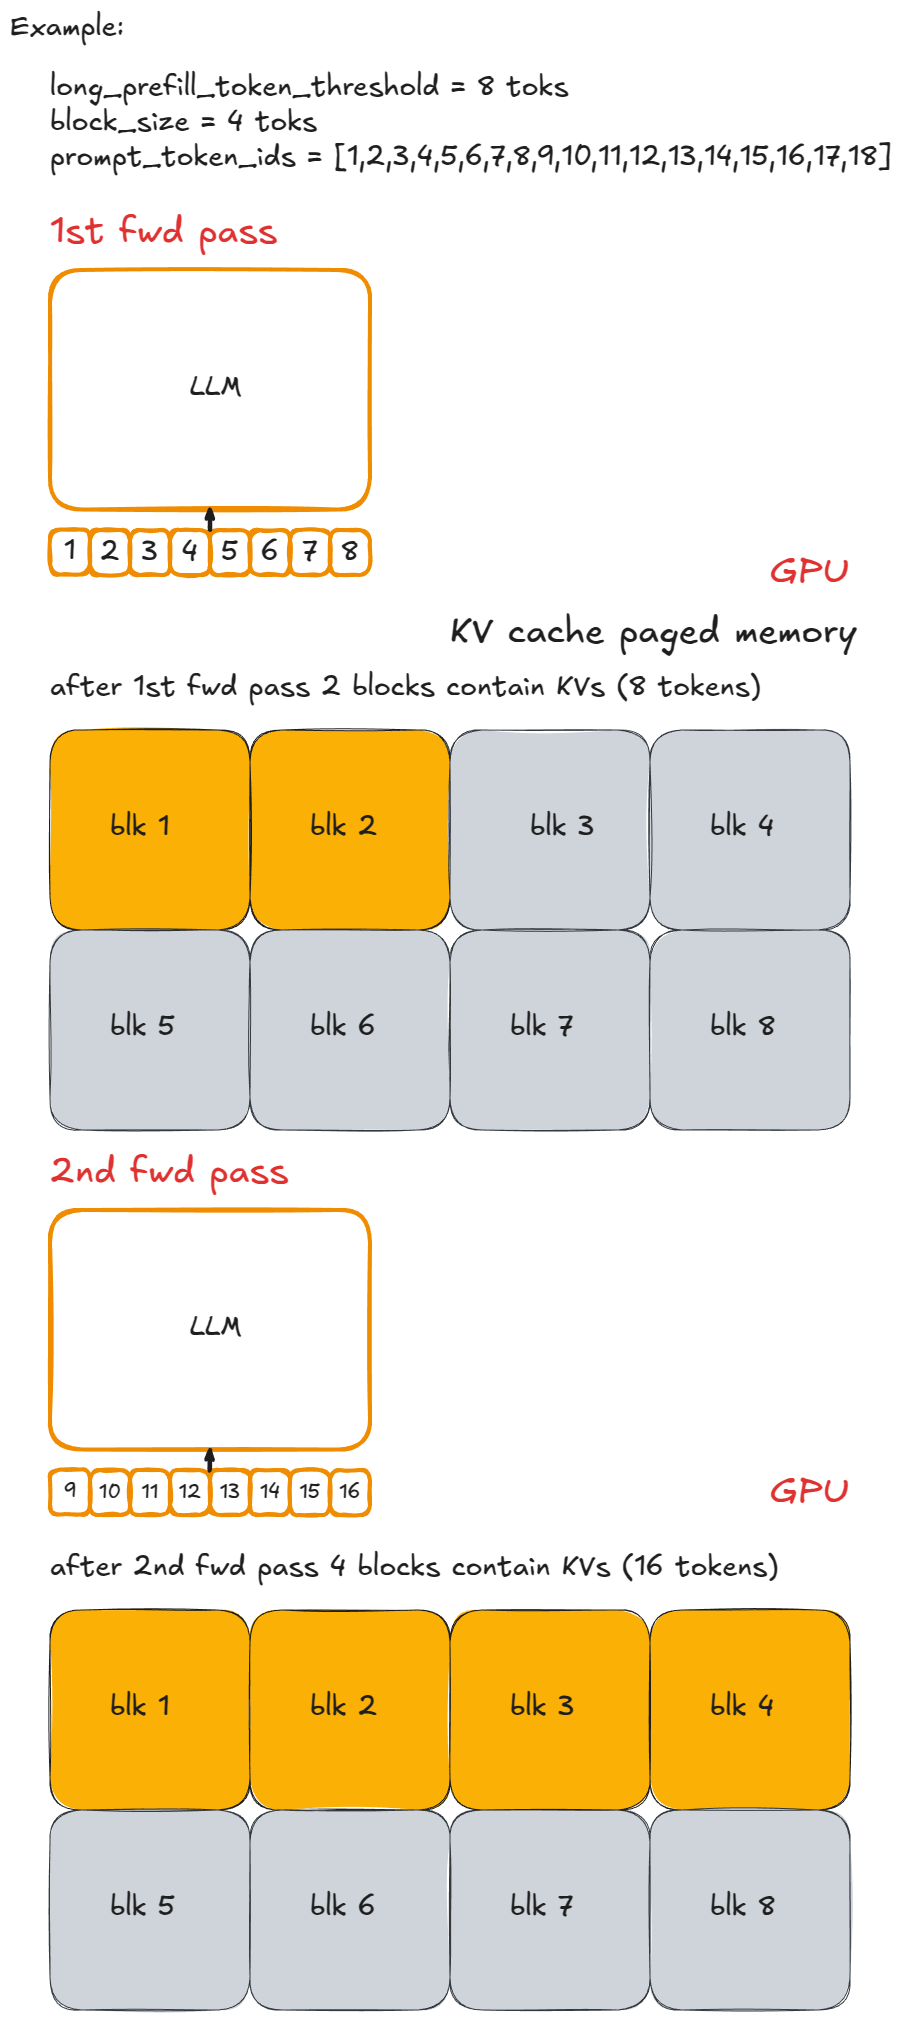
实现很直接:限制每一步的新 token 数。如果请求的数量超过 `long_prefill_token_threshold`,就把它重置为这个阈值。底层索引逻辑(前面已经描述过)会处理剩下的事。
在 vLLM V1 中,你可以把 `long_prefill_token_threshold` 设为一个正整数来启用 chunked prefill。(严格说,即使不这么设置,如果 prompt 长度超过 token budget,我们也会截断它并运行 chunked prefill。)
## Prefix Caching
为了说明 prefix caching 如何工作,我们把原来的代码例子稍微改一下:
```
from vllm import LLM, SamplingParams
long_prefix = "<a piece of text that is encoded into more than block_size tokens>"
prompts = [
"Hello, my name is",
"The president of the United States is",
]
sampling_params = SamplingParams(temperature=0.8, top_p=0.95)
def main():
llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")
outputs = llm.generate(long_prefix + prompts[0], sampling_params)
outputs = llm.generate(long_prefix + prompts[1], sampling_params)
if __name__ == "__main__":
main()
```
Prefix caching 会避免重复计算多个 prompt 开头共享的 token,也就是 **prefix**。
关键在于 `long_prefix`:它被定义为任何比一个 KV-cache block 更长的 prefix(默认 16 个 token)。为了简化例子,假设 `long_prefix` 的长度恰好是 `n x block_size`(其中 `n ≥ 1`)。
也就是说,它和 block 边界完美对齐;否则我们还得重新计算 `long_prefix_len % block_size` 个 token,因为不完整 block 不能被缓存。
如果没有 prefix caching,每次处理一个带有相同 `long_prefix` 的新请求时,我们都要重新计算所有 `n x block_size` 个 token。
有了 prefix caching,这些 token 只会计算一次(它们的 KV 被存进 KV cache paged memory),之后就可以复用,所以只需要处理新的 prompt token。这会加速 prefill 请求(但对 decode 没有帮助)。
这在 vLLM 里是怎么工作的?
第一次调用 `generate` 时,在 scheduling 阶段,在 `kv_cache_manager.get_computed_blocks` 里面,engine 会调用 `hash_request_tokens`:
1. 这个函数会把 `long_prefix + prompts[0]` 拆成 16-token chunk。
2. 对每个完整 chunk,它都会计算一个 hash(使用内置 hash,或者 SHA-256;后者更慢,但碰撞更少)。这个 hash 会组合上一个 block 的 hash、当前 token,以及可选 metadata。
可选 metadata 包括:MM hash、LoRA ID、cache salt(注入第一个 block 的 hash,确保只有带有这个 cache salt 的请求才能复用 block)。
3. 每个结果都会存为一个 `BlockHash` 对象,里面同时包含 hash 和 token ID。我们返回一个 block hash 列表。
这个列表会存到 `self.req_to_block_hashes[request_id]`。
接着,engine 调用 `find_longest_cache_hit`,检查这些 hash 是否已经存在于 `cached_block_hash_to_block`。第一个请求不会命中。
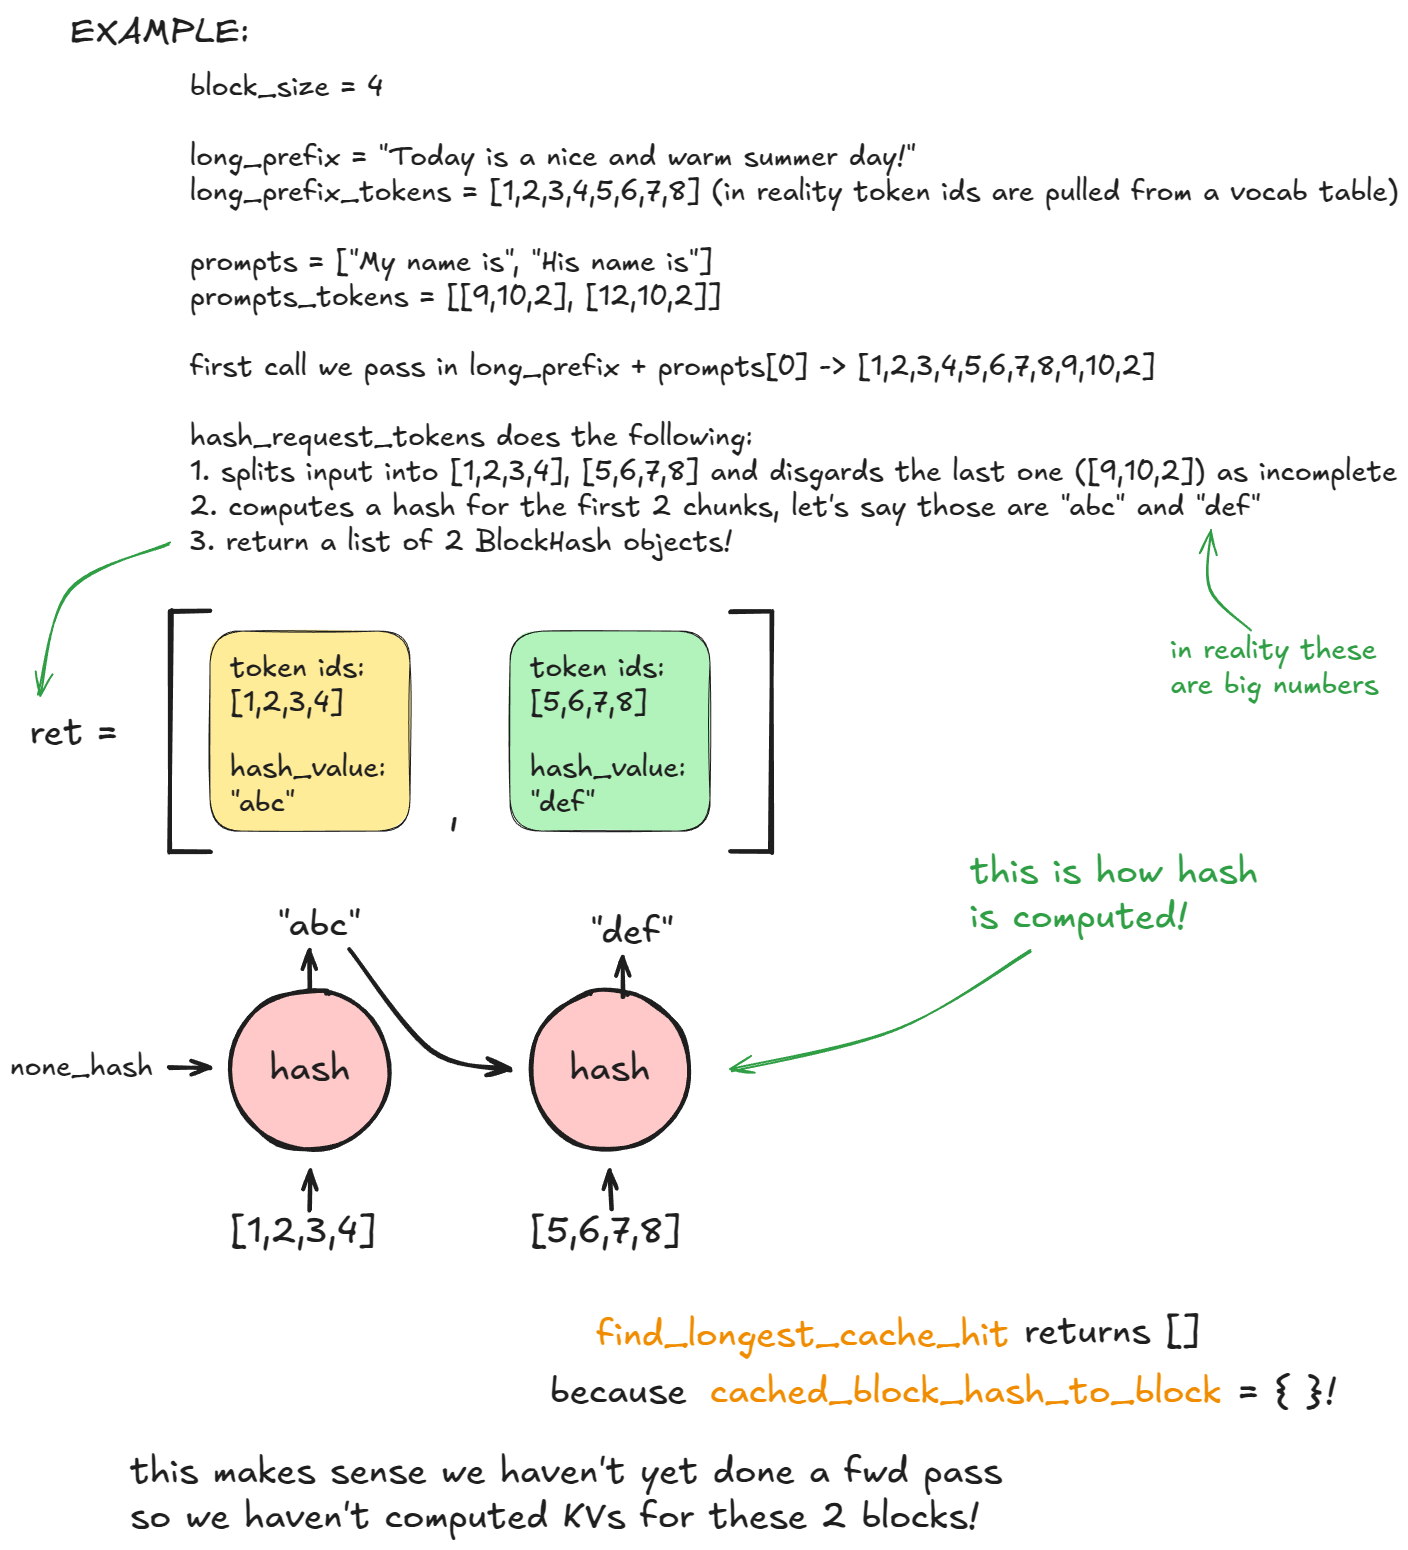
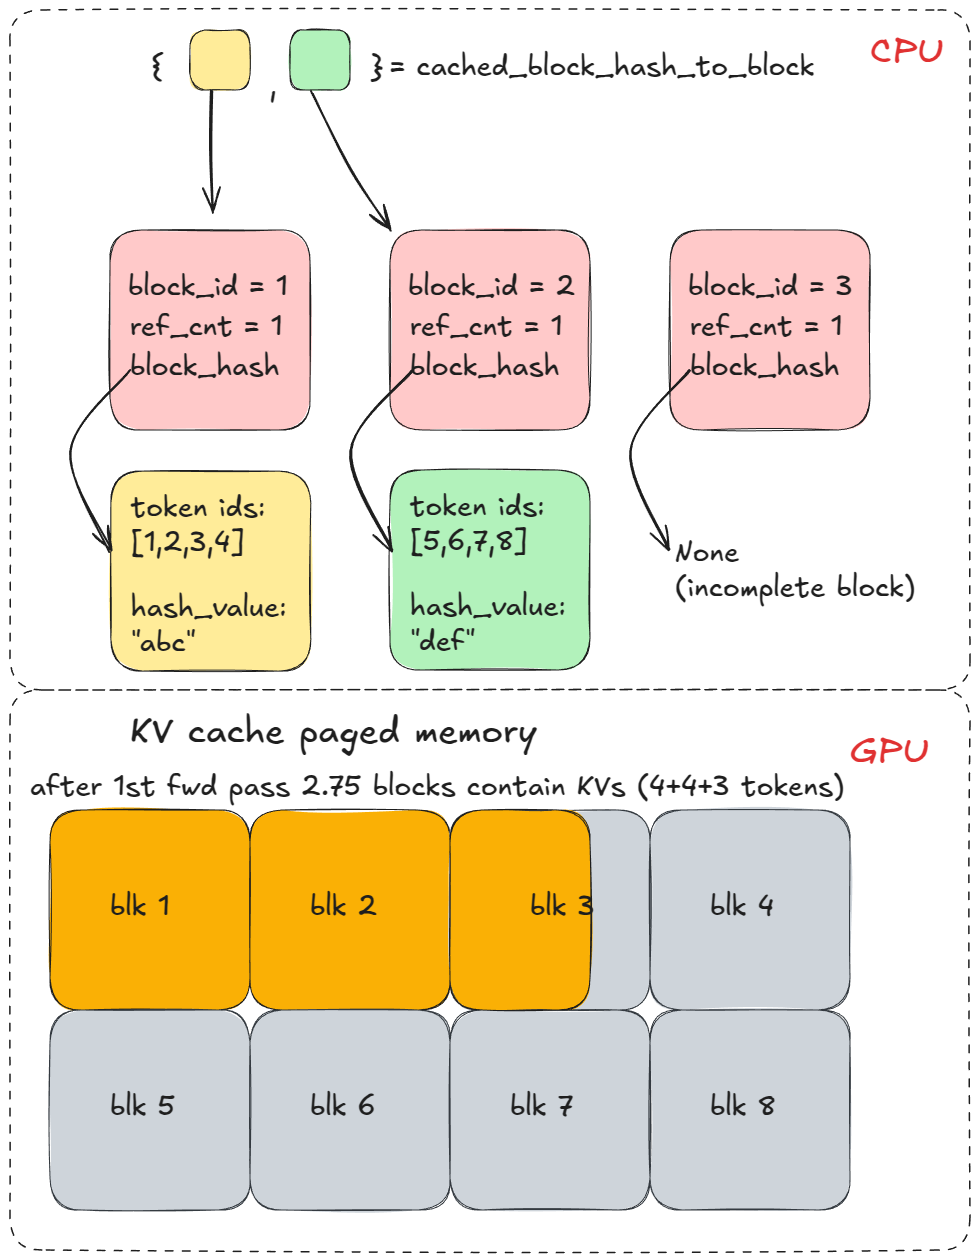
然后我们调用 `allocate_slots`,它又会调用 `coordinator.cache_blocks`,把新的 `BlockHash` 条目和分配到的 KV block 关联起来,并记录到 `cached_block_hash_to_block`。
之后,forward pass 会在 paged KV cache memory 里填充我们上面分配的 KV cache block 对应的 KV。
经过很多个 engine step 后,它会分配更多 KV cache block,但这对我们的例子没影响,因为 prefix 在 `long_prefix` 之后立刻就分叉了。
第二次用相同 prefix 调用 `generate` 时,步骤 1-3 会重复,但现在 `find_longest_cache_hit` 会找到全部 `n` 个 block 的匹配(通过线性搜索)。engine 可以直接复用这些 KV block。
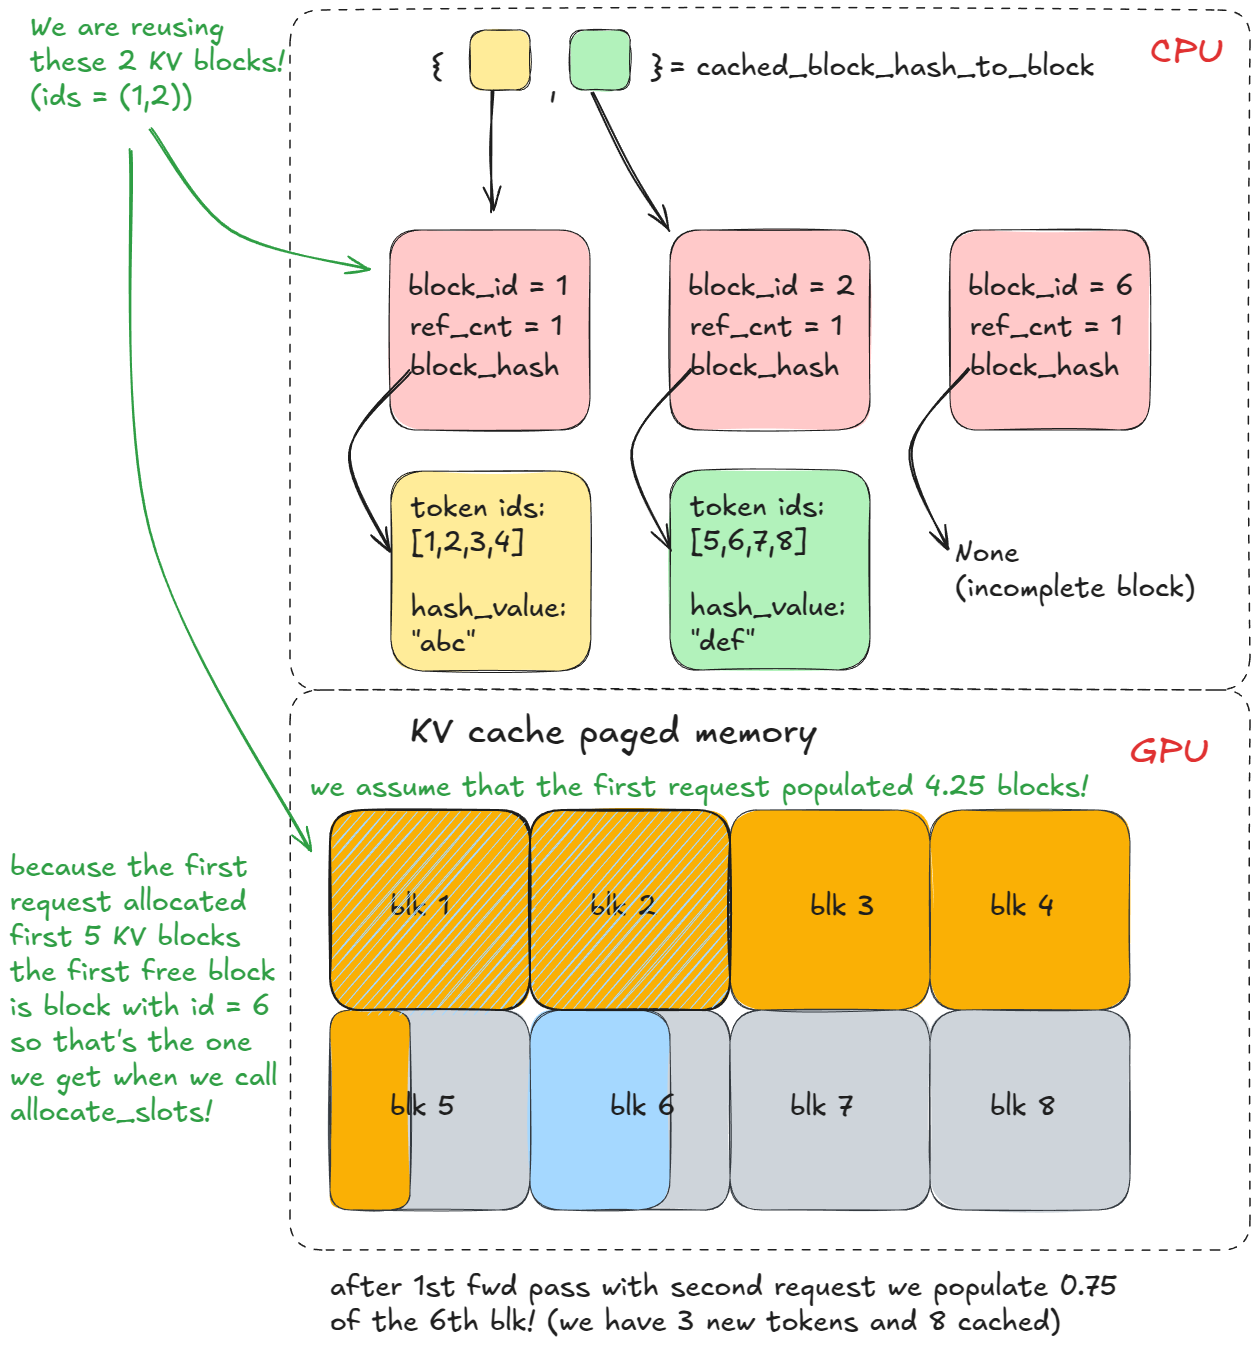
如果原来的请求还活着,这些 block 的引用计数会递增(例如变成 2)。在这个例子里,第一个请求已经完成,所以这些 block 已经被释放回池子,引用计数也被设回 0。因为我们能从 `cached_block_hash_to_block` 里取回它们,所以知道它们仍然有效(KV cache manager 的逻辑就是这样设置的),于是我们只需要再次把它们从 `free_block_queue` 中移除。
📝高级说明:
KV-cache block 只有在即将从 `free_block_queue` 重新分配时才会失效(它会从左侧 pop),并且此时我们发现该 block 仍然有关联 hash,且存在于 `cached_block_hash_to_block` 中。在那一刻,我们会清掉这个 block 的 hash,并从 `cached_block_hash_to_block` 中移除它的条目,确保它不能再通过 prefix caching 被复用(至少不能用于那个旧 prefix)。
这就是 prefix caching 的核心:不要重新计算你已经见过的 prefix,直接复用它们的 KV cache!
如果你理解了这个例子,你也就理解了 paged attention 是怎么工作的。
Prefix caching 默认启用。要禁用它:`enable_prefix_caching = False`。
## Guided Decoding(FSM)
Guided decoding 是一种技术:在每个 decoding step 中,logits 会受到基于语法的 finite state machine 约束。这能确保只有语法允许的 token 才可能被采样。
这是一个很强大的设置:你可以强制任何东西,从 regular grammar(乔姆斯基层级 type-3,例如任意 regex pattern)一直到 context-free grammar(type-2,覆盖大多数编程语言)。
为了让它不那么抽象,我们从最简单的例子开始,在前面的代码基础上改:
```
from vllm import LLM, SamplingParams
from vllm.sampling_params import GuidedDecodingParams
prompts = [
"This sucks",
"The weather is beautiful",
]
guided_decoding_params = GuidedDecodingParams(choice=["Positive", "Negative"])
sampling_params = SamplingParams(guided_decoding=guided_decoding_params)
def main():
llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")
outputs = llm.generate(prompts, sampling_params)
if __name__ == "__main__":
main()
```
在我给出的玩具例子里(假设是字符级 tokenization):在 prefill 阶段,FSM 会 mask logits,让只有 “P” 或 “N” 可选。如果采样到 “P”,FSM 就移动到 “Positive” 分支;下一步只允许 “o”,以此类推。
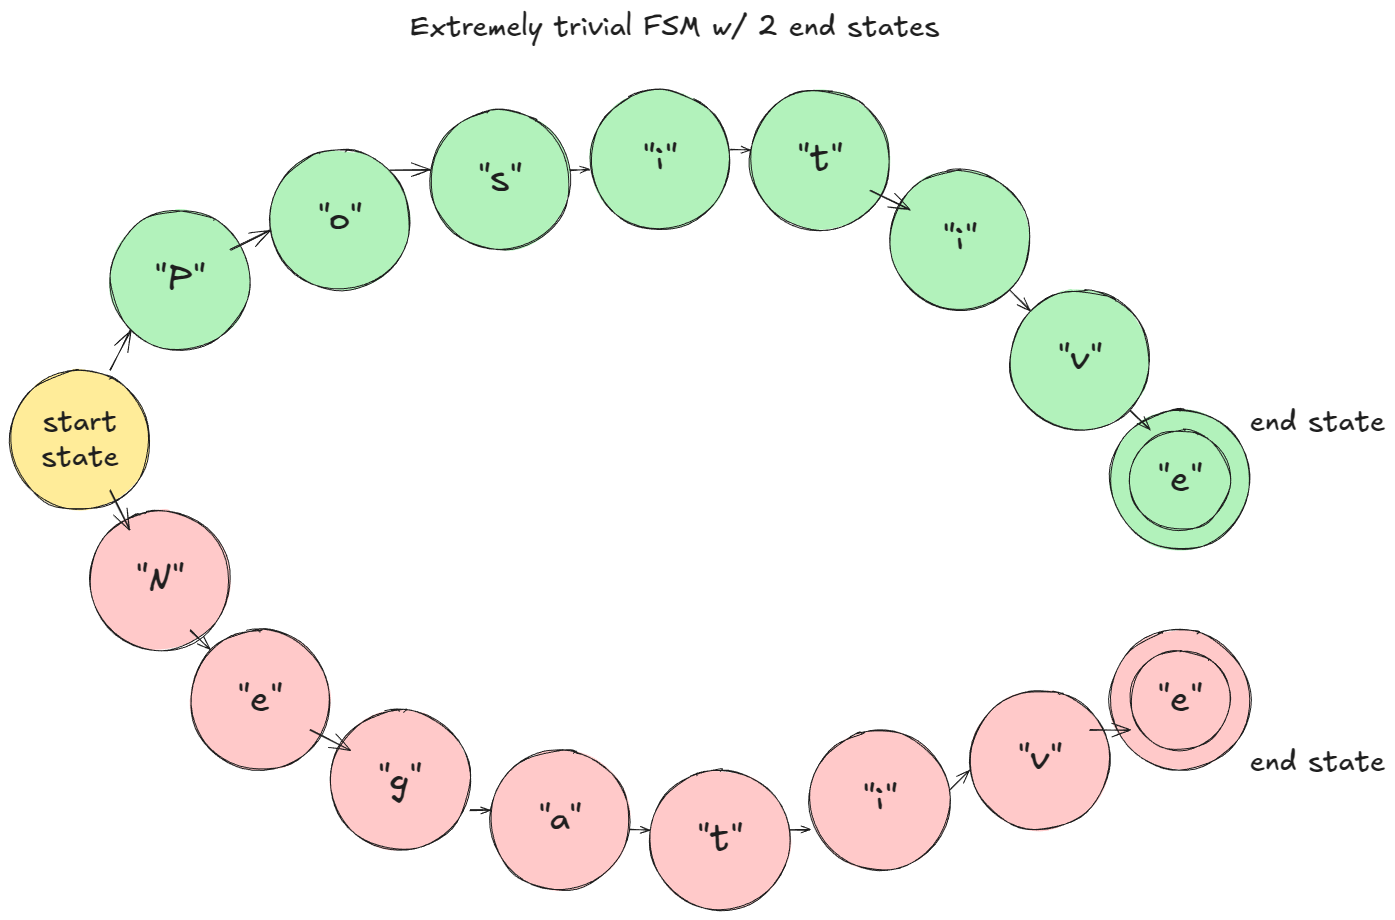
玩具示例 FSM
这在 vLLM 里是怎么工作的:
1. 构造 LLM engine 时,会创建一个 `StructuredOutputManager`;它可以访问 tokenizer,并维护一个 `_grammar_bitmask` tensor。
2. 添加请求时,请求状态会设为 `WAITING_FOR_FSM`,`grammar_init` 会选择 backend compiler(例如 `xgrammar` [[7]](#ref-7);注意 backend 是第三方代码)。
3. 这个请求的 grammar 会被异步编译。
4. 调度时,如果异步编译已经完成,状态会切换为 `WAITING`,并且 `request_id` 会被加入 `structured_output_request_ids`;否则它会被放进 `skipped_waiting_requests`,在下一个 engine step 重试。
5. 调度循环结束后(仍然在 scheduling 里面),如果有 FSM 请求,`StructuredOutputManager` 会让 backend 准备 / 更新 `_grammar_bitmask`。
6. Forward pass 产生 logits 后,xgr\_torch\_compile 的函数会把 bitmask 扩展到 vocab size(32 倍扩展比例,因为我们使用 32-bit integer),并把不允许的 logits mask 到 –∞。
7. 采样下一个 token 之后,请求的 FSM 会通过 `accept_tokens` 前进一步。视觉上看,就是在 FSM 图上移动到下一个状态。
第 6 步值得进一步说明。
如果 `vocab_size = 32`,`_grammar_bitmask` 就是一个整数;它的二进制表示编码了哪些 token 被允许(“1”)和哪些 token 不被允许(“0”)。例如,“101…001” 会扩展成一个长度为 32 的数组 `[1, 0, 1, …, 0, 0, 1]`;值为 0 的位置会把 logits 设为 –∞。对于更大的 vocabulary,会使用多个 32-bit word,并相应地扩展 / 拼接。backend(例如 `xgrammar`)负责根据当前 FSM state 生成这些 bit pattern。
📝说明:
这里的大部分复杂度都藏在 xgrammar 这样的第三方库里。
下面是一个更简单的例子,vocab\_size = 8,使用 8-bit integer(给喜欢我这些图的人):
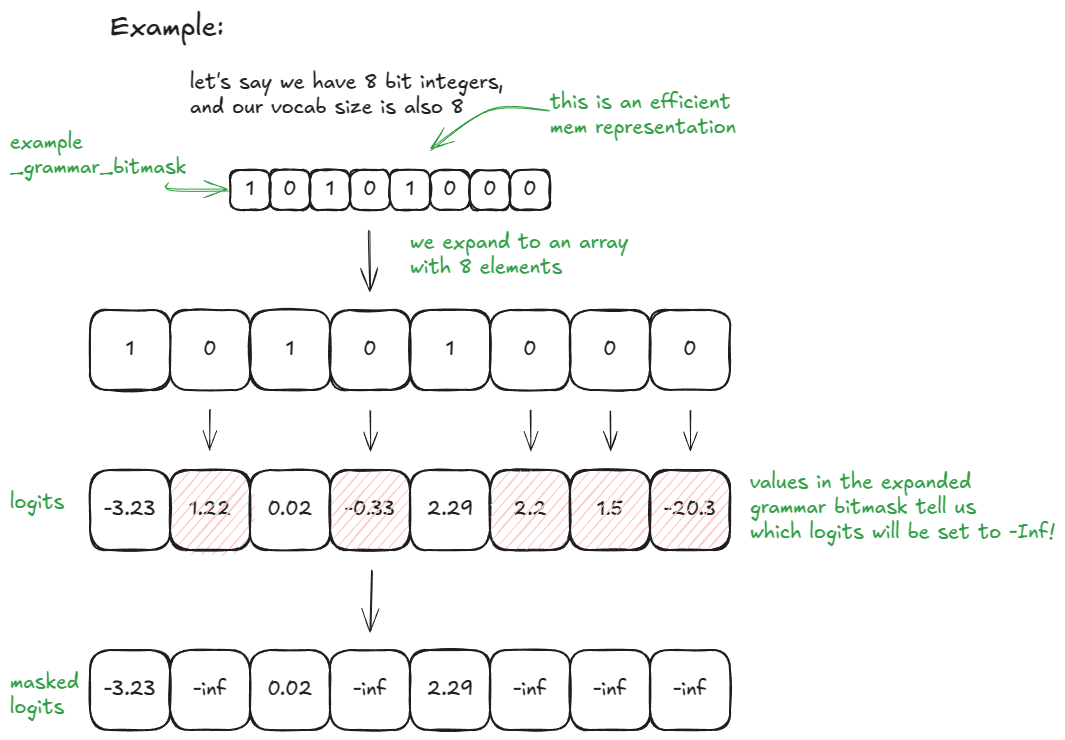
玩具例子
你可以通过传入想要的 `guided_decoding` 配置,在 vLLM 中启用它。
## Speculative Decoding
在自回归生成中,每个新 token 都需要大 LM 做一次 forward pass。这很贵:每一步都要重新加载并应用全部模型权重,只为了计算一个 token!(假设 batch size == 1;一般来说是 `B`)
Speculative decoding [[8]](#ref-8) 通过引入一个更小的 draft LM 来加速这个过程。draft 会便宜地提出 `k` 个 token。但我们最终并不想从这个小模型采样;它只是用来猜候选续写。真正决定什么有效的仍然是大模型。
步骤如下:
1. **Draft:** 在当前 context 上运行小模型,提出 `k` 个 token
2. **Verify:** 在 context + `k` 个 draft token 上运行一次大模型。这会为这 `k` 个位置再加一个额外位置产生概率(所以我们得到 `k+1` 个候选)
3. **Accept/reject:** 从左到右遍历这 `k` 个 draft token:
- 如果大模型给 draft token 的概率 ≥ draft 自己给它的概率,就接受它
- 否则,以 `p_large(token)/p_draft(token)` 的概率接受它
- 在第一个 rejection 处停止,或者接受全部 `k` 个 draft token。
- 如果全部 `k` 个 draft token 都被接受,也可以从大模型“免费”采样额外的第 `(k+1)` 个 token(这个分布我们已经算出来了)。
- 如果出现 rejection,就在那个位置创建一个新的重平衡分布(`p_large - p_draft`,最小值 clamp 到 0,再归一化到总和为 1),并从中采样最后一个 token。
**为什么这样可行:** 虽然我们用小模型提出候选,但 accept/reject 规则保证,从期望上看,序列的分布和逐 token 从大模型采样完全一致。这意味着 speculative decoding 在统计上等价于标准自回归 decoding,但可能快得多,因为一次大模型 pass 最多可以产出 `k+1` 个 token。
📝说明:
我建议看一下 [gpt-fast](https://github.com/meta-pytorch/gpt-fast) 的简单实现,以及[原论文](https://arxiv.org/abs/2302.01318)里的数学细节和与完整模型采样等价的证明。
vLLM V1 不支持 LLM draft model 方法,而是实现了更快但没那么准确的 proposal 方案:n-gram、EAGLE [[9]](#ref-9) 和 Medusa [[10]](#ref-10)。
每种方法一句话说明:
1. **n-gram:** 取最后 `prompt_lookup_max` 个 token;在序列中寻找之前的匹配;如果找到,就提出那个匹配后面的 `k` 个 token;否则缩小窗口并重试,一直降到 `prompt_lookup_min`
当前实现会返回**第一个**匹配后面的 `k` 个 token。我感觉加入 recency bias、反过来搜索会更自然?(也就是最后一个匹配)
2. **Eagle:** 对大 LM 做 “model surgery”:保留 embedding 和 LM head,把 transformer stack 换成轻量 MLP;再把它 fine-tune 成一个便宜的 draft
3. **Medusa:** 在大模型顶部(LM head 之前的 embedding)训练辅助 linear head,并行预测接下来的 `k` 个 token;相比单独跑一个小 LM,用这些 head 提出 token 会更高效
下面是在 vLLM 中使用 `ngram` 作为 draft method 来调用 speculative decoding 的方式:
```
from vllm import LLM, SamplingParams
prompts = [
"Hello, my name is",
"The president of the United States is",
]
sampling_params = SamplingParams(temperature=0.8, top_p=0.95)
speculative_config={
"method": "ngram",
"prompt_lookup_max": 5,
"prompt_lookup_min": 3,
"num_speculative_tokens": 3,
}
def main():
llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", speculative_config=speculative_config)
outputs = llm.generate(prompts, sampling_params)
if __name__ == "__main__":
main()
```
这在 vLLM 里是怎么工作的?
**设置阶段(engine 构造时):**
1. 初始化设备:创建一个 `drafter`(draft model,例如 `NgramProposer`)和一个 `rejection_sampler`(其中一部分用 Triton 编写)。
2. 加载模型:加载 draft model 权重(对 n-gram 来说是 no-op)。
**之后在 `generate` 函数中**(假设我们拿到一个全新请求):
1. 用大模型运行常规 prefill step。
2. 在 forward pass 和标准采样之后,调用 `propose_draft_token_ids(k)`,从 draft model 采样 `k` 个 draft token。
3. 把它们存到 `request.spec_token_ids`(更新 request metadata)。
4. 在下一个 engine step 中,当请求位于 running 队列时,把 `len(request.spec_token_ids)` 加到“new tokens”计数上,让 `allocate_slots` 为 fwd pass 预留足够的 KV block。
5. 把 `spec_token_ids` 拷贝到 `input_batch.token_ids_cpu`,形成(context + draft)token。
6. 通过 `_calc_spec_decode_metadata` 计算 metadata(这会从 `input_batch.token_ids_cpu` 复制 token,准备 logits 等),然后在 draft token 上运行一次大模型 forward pass。
7. 不再对 logits 做常规采样,而是使用 `rejection_sampler` 从左到右 accept/reject,并产生 `output_token_ids`。
8. 重复步骤 2-7,直到满足停止条件。
真正理解它的最好方式,是打开 debugger,在代码库里一步步跟进去;但这一节希望能给你一点感觉。还有这个:
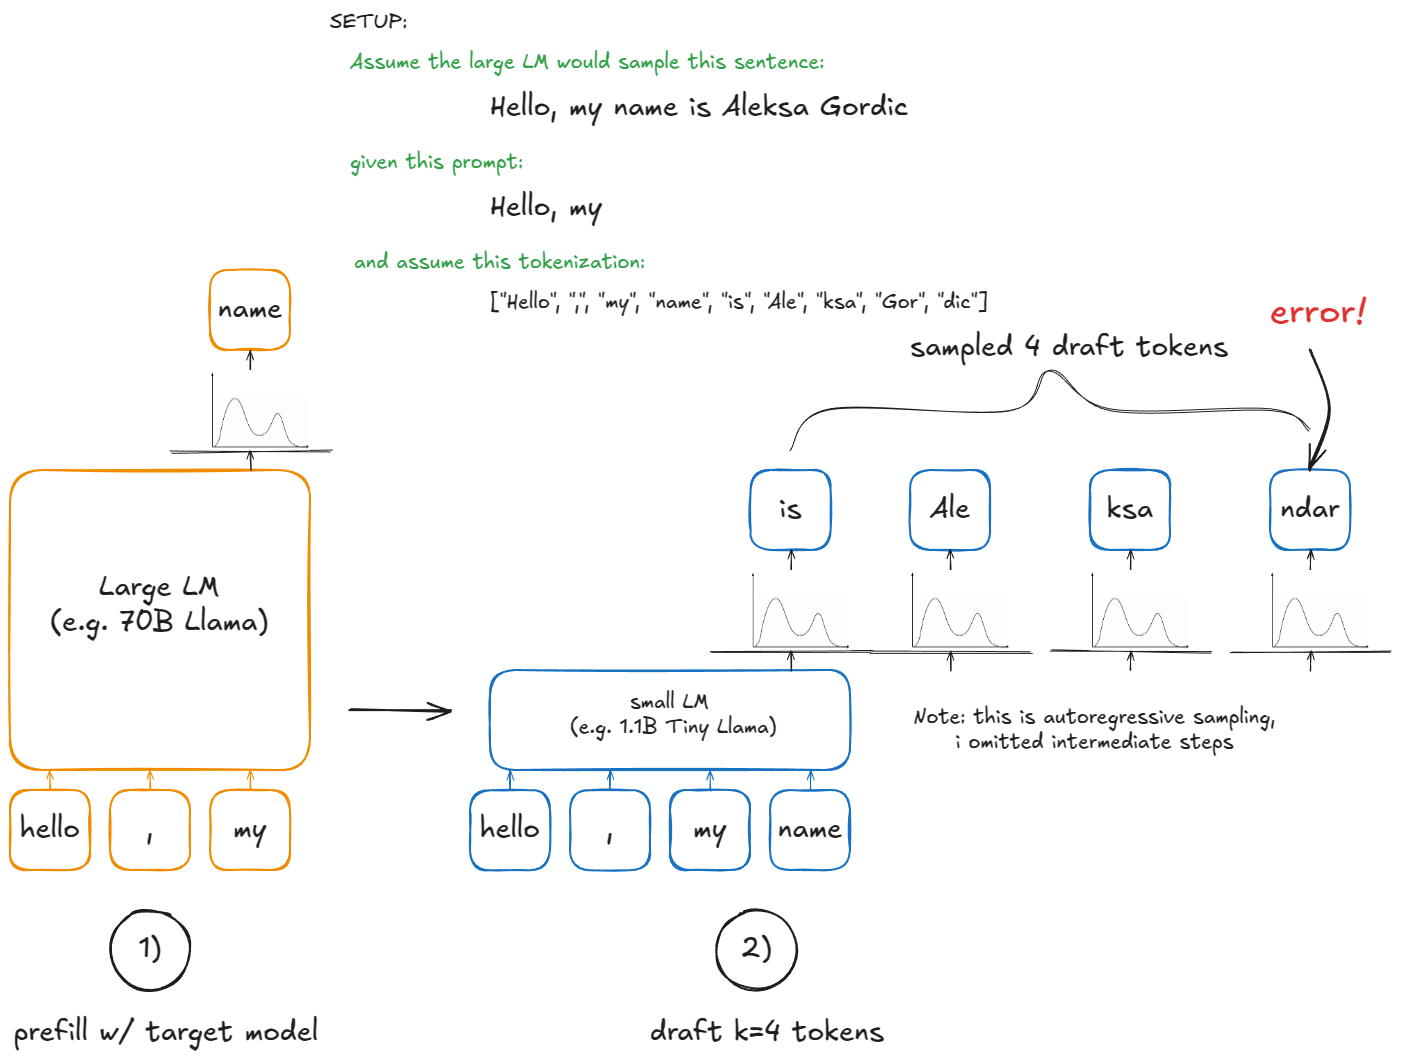
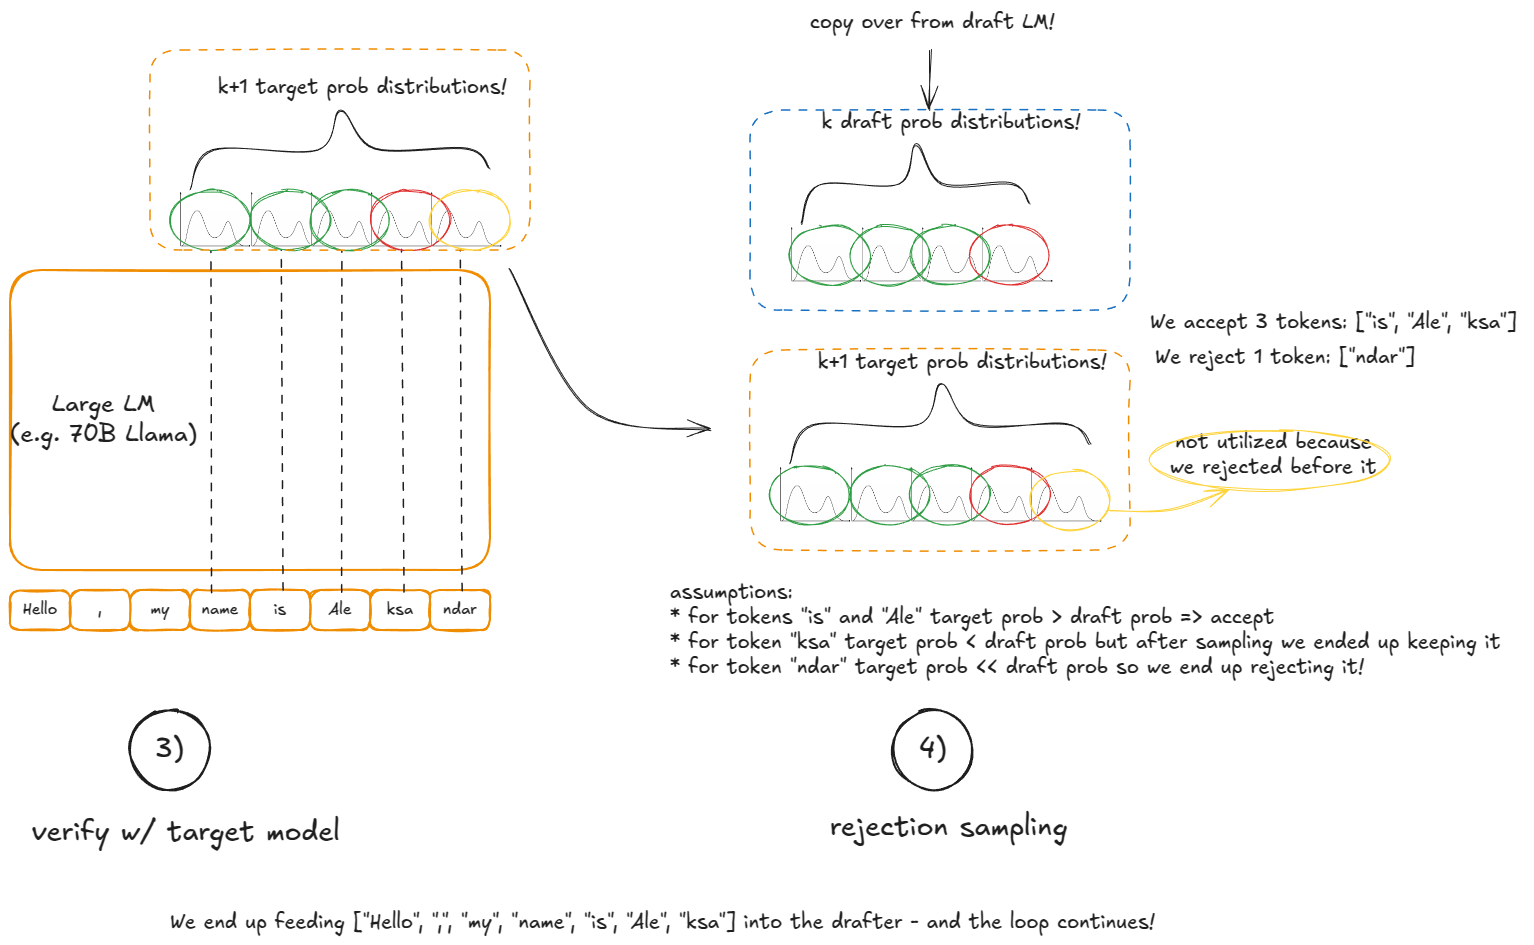
## Disaggregated P/D
我前面已经暗示过 disaggregated P/D(prefill/decode)的动机。
Prefill 和 decode 的性能画像非常不同(compute-bound vs. memory-bandwidth-bound),所以把它们的执行拆开是一个合理设计。这样可以更精细地控制延迟,包括 `TTFT`(time-to-first-token)和 `ITL`(inter-token latency)。更多内容会在 [benchmark](#cpt5) 一节展开。
实践中,我们会运行 `N` 个 vLLM prefill instance 和 `M` 个 vLLM decode instance,并根据实时请求组合对它们做 autoscaling。Prefill worker 把 KV 写入一个专用 KV-cache service;decode worker 从中读取。这会把长而突发的 prefill 和稳定、对延迟敏感的 decode 隔离开。
这在 vLLM 里是怎么工作的?
为了讲清楚,下面的例子依赖 `SharedStorageConnector`,这是一个用于展示机制的调试 connector 实现。
Connector 是 vLLM 里处理 instance 之间 KV 交换的抽象。Connector interface 还不稳定,近期计划做一些改进,可能会引入变更,其中一些可能是 breaking change。
我们启动 2 个 vLLM instance(GPU 0 用于 prefill,GPU 1 用于 decode),然后在它们之间传输 KV cache:
```
import os
import time
from multiprocessing import Event, Process
import multiprocessing as mp
from vllm import LLM, SamplingParams
from vllm.config import KVTransferConfig
prompts = [
"Hello, my name is",
"The president of the United States is",
]
def run_prefill(prefill_done):
os.environ["CUDA_VISIBLE_DEVICES"] = "0"
sampling_params = SamplingParams(temperature=0, top_p=0.95, max_tokens=1)
ktc=KVTransferConfig(
kv_connector="SharedStorageConnector",
kv_role="kv_both",
kv_connector_extra_config={"shared_storage_path": "local_storage"},
)
llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", kv_transfer_config=ktc)
llm.generate(prompts, sampling_params)
prefill_done.set() # notify decode instance that KV cache is ready
# To keep the prefill node running in case the decode node is not done;
# otherwise, the script might exit prematurely, causing incomplete decoding.
try:
while True:
time.sleep(1)
except KeyboardInterrupt:
print("Script stopped by user.")
def run_decode(prefill_done):
os.environ["CUDA_VISIBLE_DEVICES"] = "1"
sampling_params = SamplingParams(temperature=0, top_p=0.95)
ktc=KVTransferConfig(
kv_connector="SharedStorageConnector",
kv_role="kv_both",
kv_connector_extra_config={"shared_storage_path": "local_storage"},
)
llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", kv_transfer_config=ktc)
prefill_done.wait() # block waiting for KV cache from prefill instance
# Internally it'll first fetch KV cache before starting the decoding loop
outputs = llm.generate(prompts, sampling_params)
if __name__ == "__main__":
prefill_done = Event()
prefill_process = Process(target=run_prefill, args=(prefill_done,))
decode_process = Process(target=run_decode, args=(prefill_done,))
prefill_process.start()
decode_process.start()
decode_process.join()
prefill_process.terminate()
```
📝说明:
我也试过 `LMCache` [[11]](#ref-11),这是最快的 production-ready connector(使用 NVIDIA 的 NIXL 作为 backend),但它还处在最前沿,我遇到了一些 bug。由于它的大量复杂性存在于外部 repo 中,`SharedStorageConnector` 更适合用来解释。
vLLM 中的步骤如下:
1. **实例化**:构造 engine 时,connector 会在两个地方创建:
- 在 worker 的 init device 过程中(位于 init worker distributed environment 函数下面),角色是 “worker”。
- 在 scheduler 构造函数中,角色是 “scheduler”。
2. **Cache lookup**:当 scheduler 从 `waiting` 队列处理 prefill 请求时(在本地 prefix-cache 检查之后),它会调用 connector 的 `get_num_new_matched_tokens`。这会检查 KV-cache server 中是否有外部缓存的 token。Prefill 在这里总是看到 0;decode 可能会 cache hit。结果会加入本地计数,然后再调用 `allocate_slots`。
3. **状态更新**:scheduler 接着调用 `connector.update_state_after_alloc`,记录那些命中 cache 的请求(对 prefill 是 no-op)。
4. **构建 meta**:在 scheduling 结束时,scheduler 调用 `meta = connector.build_connector_meta`:
- Prefill 会加入所有 `is_store=True` 的请求(用于上传 KV)。
- Decode 会加入 `is_store=False` 的请求(用于拉取 KV)。
5. **Context manager**:forward pass 之前,engine 会进入一个 KV-connector context manager:
- 进入时:调用 `kv_connector.start_load_kv`。对 decode 来说,这会从外部 server 加载 KV,并注入 paged memory。对 prefill 来说,这是 no-op。
- 退出时:调用 `kv_connector.wait_for_save`。对 prefill 来说,这会阻塞到 KV 上传到外部 server 为止。对 decode 来说,这是 no-op。
下面是一个图示例子:
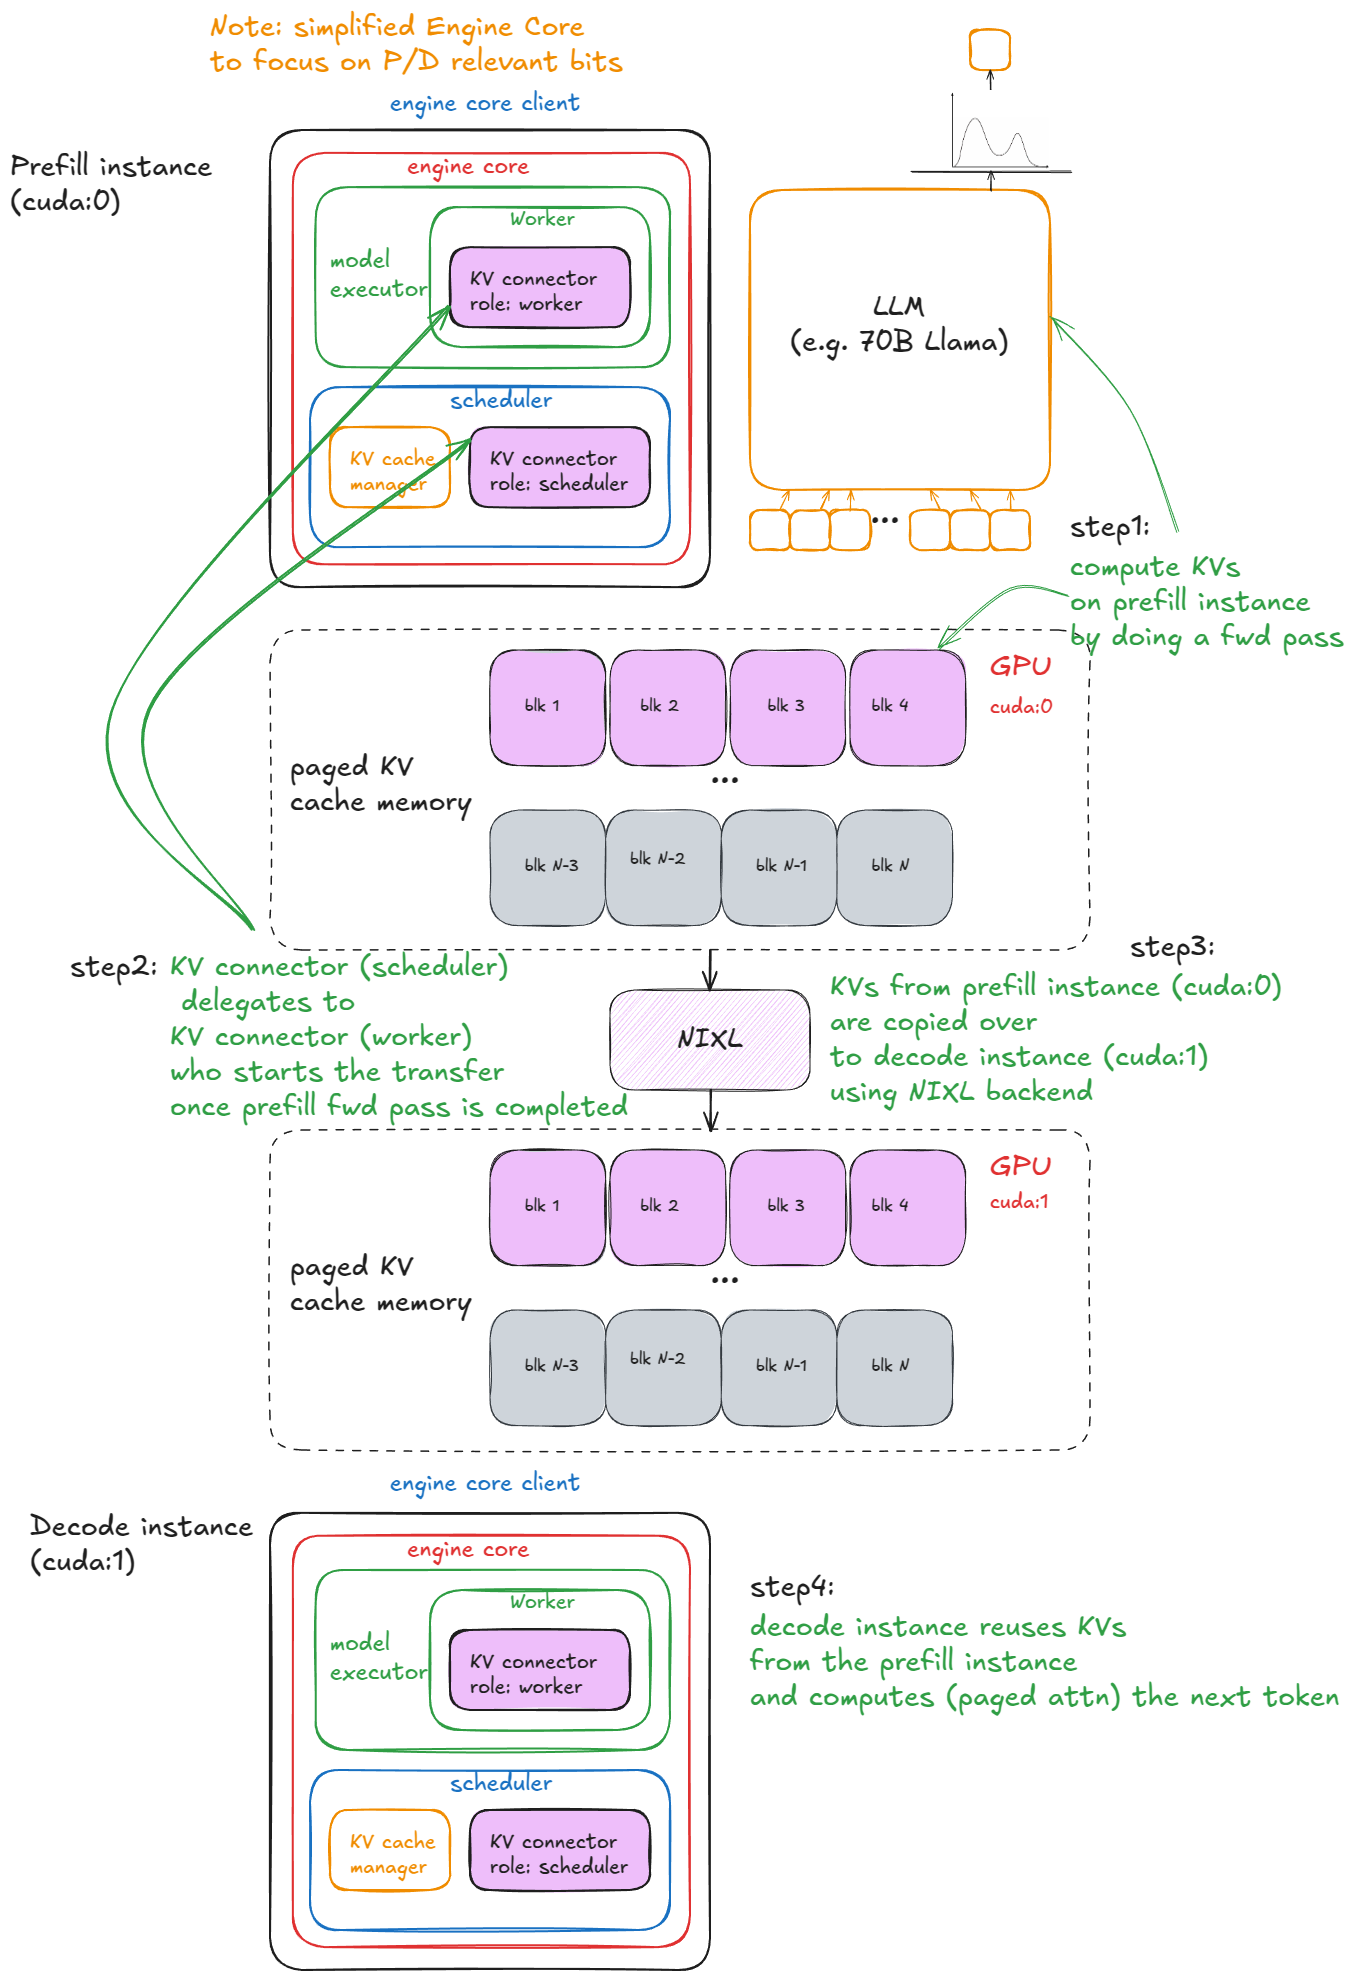
disaggregated P/D
📝补充说明:
- 对 `SharedStorageConnector` 来说,“external server” 只是本地文件系统。
- 根据配置,KV 传输也可以逐层完成(在每个 attention layer 之前 / 之后)。
- Decode 只会在其请求的第一步加载一次外部 KV;之后它会在本地计算 / 存储。
## 从 UniprocExecutor 到 MultiProcExecutor
有了核心技术之后,我们现在可以谈谈扩展。
假设你的模型权重已经放不进单个 GPU 的 VRAM。
第一个选择,是在同一节点上的多个 GPU 之间使用 tensor parallelism 对模型做 shard(例如 `TP=8`)。如果模型还是放不下,下一步就是跨节点使用 pipeline parallelism。
📝说明:
- 节点内带宽明显高于节点间带宽,这就是为什么 tensor parallelism(TP)通常优先于 pipeline parallelism(PP)。(PP 传输的数据确实也比 TP 少。)
- 我不会讲 expert parallelism(EP),因为我们关注的是标准 transformer,而不是 MoE;也不会讲 sequence parallelism,因为 TP 和 PP 是实践中最常用的。
到这个阶段,我们需要多个 GPU 进程(worker)和一个协调它们的 orchestration layer。这正是 `MultiProcExecutor` 提供的东西。
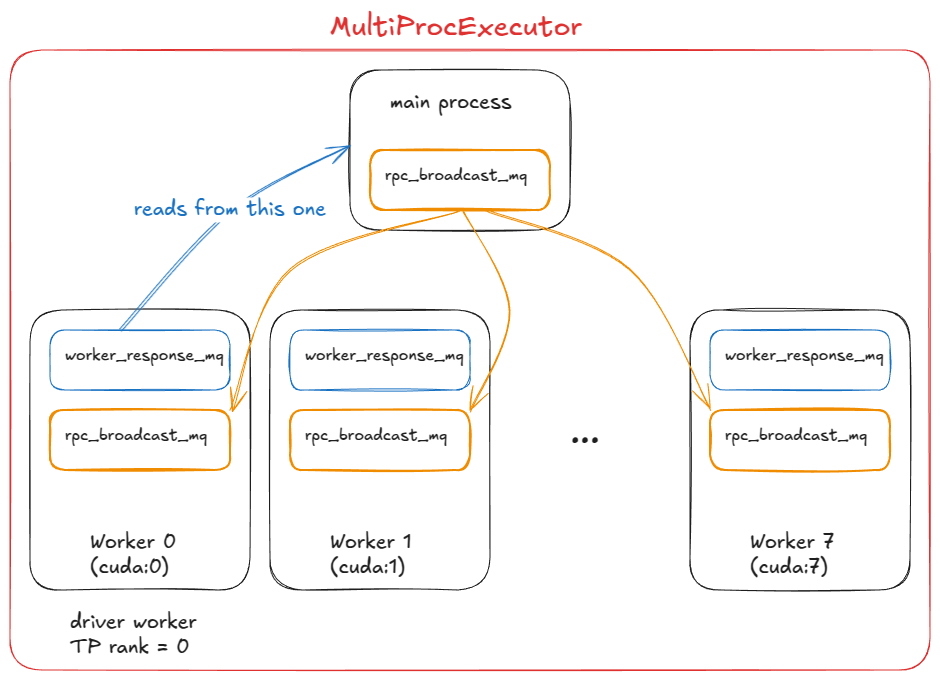
TP=8 设置下的 MultiProcExecutor(driver worker 是 rank 0)
这在 vLLM 里是怎么工作的:
1. `MultiProcExecutor` 初始化一个 `rpc_broadcast_mq` 消息队列(底层用 shared memory 实现)。
2. 构造函数遍历 `world_size`(例如 `TP=8 ⇒ world_size=8`),并通过 `WorkerProc.make_worker_process` 为每个 rank 启动一个 daemon process。
3. 对每个 worker,parent 首先创建 reader pipe 和 writer pipe。
4. 新进程运行 `WorkerProc.worker_main`,它会实例化一个 worker(经历和 `UniprocExecutor` 中相同的 “init device”“load model” 等流程)。
5. 每个 worker 会判断自己是 driver(TP group 中的 rank 0)还是普通 worker。每个 worker 都会设置两个队列:
- `rpc_broadcast_mq`(与 parent 共享),用于接收工作。
- `worker_response_mq`,用于发回响应。
6. 初始化期间,每个 child 会通过 pipe 把自己的 `worker_response_mq` handle 发给 parent。等全部收到后,parent 解除阻塞,协调完成。
7. 然后 worker 进入 busy loop,在 `rpc_broadcast_mq.dequeue` 上阻塞。工作项到达时,它们会执行它(和 `UniprocExecutor` 中一样,只是现在带有 TP/PP 特定的分区工作)。结果通过 `worker_response_mq.enqueue` 发回。
8. 运行时,请求到达后,`MultiProcExecutor` 会把它 enqueue 到 `rpc_broadcast_mq`(非阻塞),发给所有 child worker。然后它在指定 output rank 的 `worker_response_mq.dequeue` 上等待,收集最终结果。
从 engine 的角度看,什么都没变:所有这些 multiprocessing 复杂性都被抽象在对 model executor 的 `execute_model` 调用后面。
- 在 `UniProcExecutor` 的情况下:execute\_model 会直接导致在 worker 上调用 execute\_model
- 在 `MultiProcExecutor` 的情况下:execute\_model 会通过 `rpc_broadcast_mq` 间接导致在每个 worker 上调用 execute\_model
到这里,我们可以用同一个 engine interface 运行资源允许范围内尽可能大的模型。
下一步是横向扩展:启用 data parallelism(`DP > 1`),在多个节点上复制模型,加入轻量 DP 协调层,在 replica 之间做负载均衡,并在前面放置一个或多个 API server 来处理进入的流量。
## 分布式系统服务 vLLM
搭建服务基础设施有很多方式,但为了保持具体,我们来看一个例子:假设我们有两个 H100 节点,并希望在它们之上运行四个 vLLM engine。
如果模型需要 `TP=4`,可以这样配置节点。
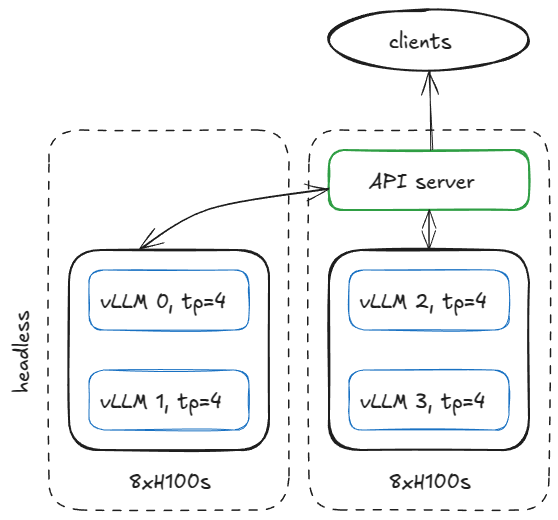
2 个 8xH100 节点的 server 配置(1 个 headless,1 个 api server)
在第一个节点上,用下面的参数以 headless mode(没有 API server)运行 engine:
```
vllm serve <model-name>
--tensor-parallel-size 4
--data-parallel-size 4
--data-parallel-size-local 2
--data-parallel-start-rank 0
--data-parallel-address <master-ip>
--data-parallel-rpc-port 13345
--headless
```
然后在另一个节点上运行同样的命令,只做少量调整:
- 去掉 `--headless`
- 修改 DP start rank
```
vllm serve <model-name>
--tensor-parallel-size 4
--data-parallel-size 4
--data-parallel-size-local 2
--data-parallel-start-rank 2
--data-parallel-address <master-ip>
--data-parallel-rpc-port 13345
```
📝说明:
这假设网络已经配置好,所有节点都能访问指定的 IP 和端口。
这在 VLLM 里是怎么工作的?
## 在 headless server 节点上
在 headless 节点上,`CoreEngineProcManager` 会启动 2 个进程(对应 `--data-parallel-size-local`),每个进程都运行 `EngineCoreProc.run_engine_core`。每个函数都会创建一个 `DPEngineCoreProc`(engine core),然后进入它的 busy loop。
`DPEngineCoreProc` 会初始化它的 parent `EngineCoreProc`(`EngineCore` 的 child),后者会:
1. 创建一个 `input_queue` 和 `output_queue`(`queue.Queue`)。
2. 使用 `DEALER` ZMQ socket(异步消息库)和另一个节点上的 frontend 做一次初始 handshake,并接收协调地址信息。
3. 初始化 DP group(例如使用 NCCL backend)。
4. 初始化 `EngineCore`,使用 `MultiProcExecutor`(如前所述,在 4 个 GPU 上 `TP=4`)。
5. 创建一个 `ready_event`(`threading.Event`)。
6. 启动一个 input daemon thread(`threading.Thread`),运行 `process_input_sockets(…, ready_event)`。类似地启动一个 output thread。
7. 仍然在 main thread 中,等待 `ready_event`,直到跨 2 个节点的全部 4 个进程中的所有 input thread 都完成协调 handshake,最终执行 `ready_event.set()`。
8. 解除阻塞后,向 frontend 发送一条 “ready” 消息,附带 metadata(例如 paged KV cache memory 中可用的 `num_gpu_blocks`)。
9. main、input 和 output thread 随后分别进入各自的 busy loop。
TL;DR:最终我们会得到 4 个 child process(每个 DP replica 一个),每个都运行一个 main、input 和 output thread。它们和 DP coordinator 以及 frontend 完成协调 handshake,然后每个进程里的三个 thread 都进入 steady-state busy loop。
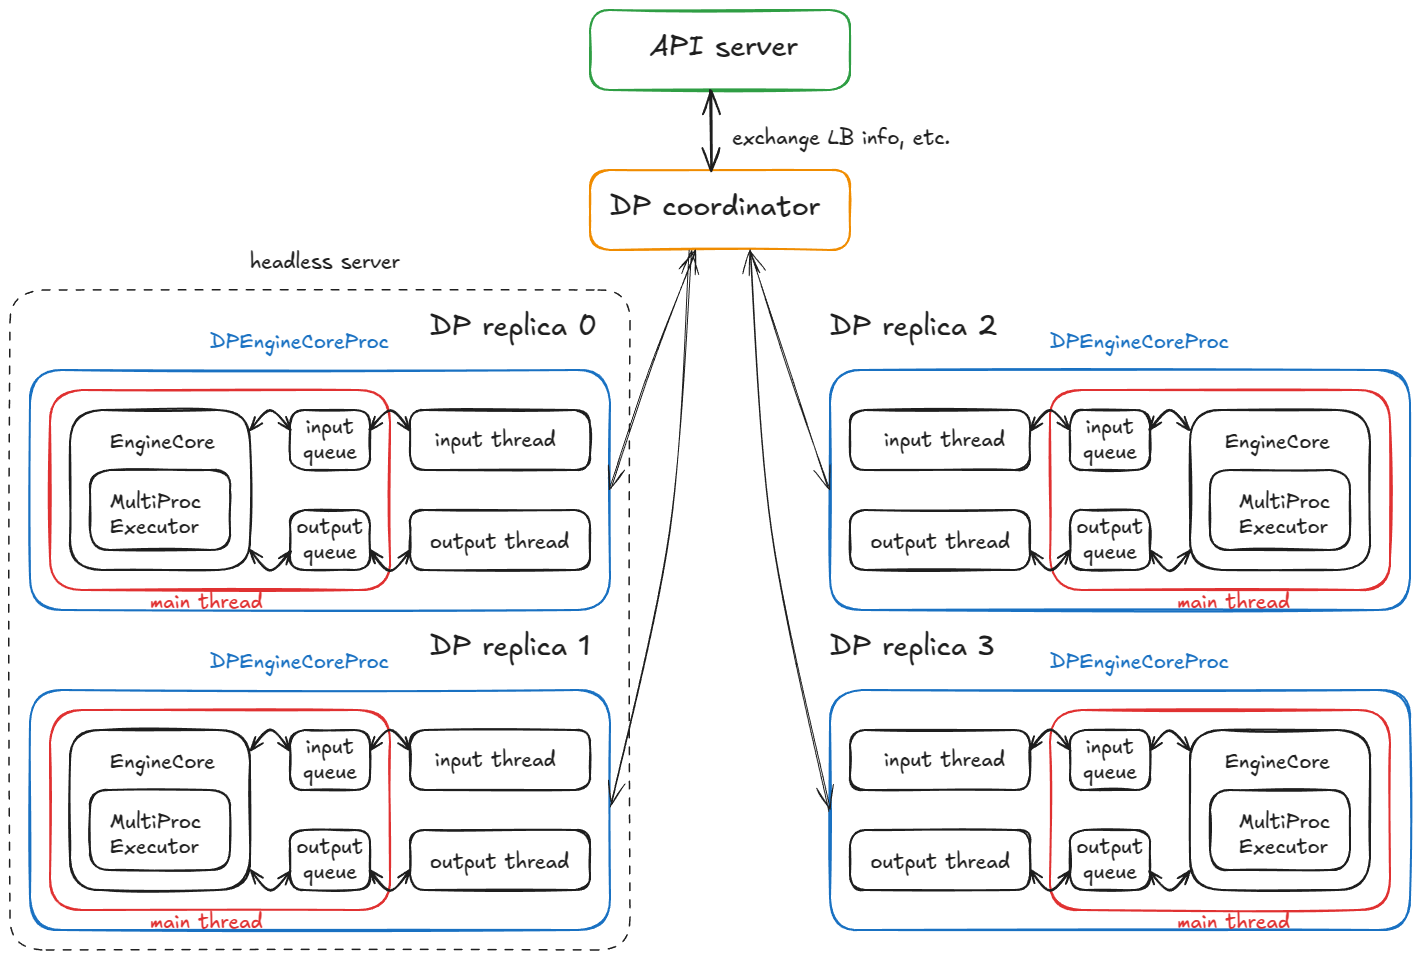
运行 4 个 DPEngineCoreProc 的分布式系统,其中有 4 个 DP replica
**当前 steady state:**
- **Input thread**:在 input socket 上阻塞,直到 API server 路由来一个请求;收到后,解码 payload,通过 `input_queue.put_nowait(...)` enqueue 一个 work item,然后回到 socket 上继续阻塞。
- **Main thread**:在 `input_queue.get(...)` 上醒来,把请求喂给 engine;`MultiProcExecutor` 运行 forward pass,并把结果 enqueue 到 `output_queue`。
- **Output thread**:在 `output_queue.get(...)` 上醒来,把结果发回 API server,然后恢复阻塞。
**补充机制:**
- **DP wave counter**:系统会跟踪 “wave”;当所有 engine 变为空闲时,它们会 quiesce;新工作到来时,counter 会递增(这对协调 / 指标有用)。
- **Control messages**:API server 不只可以发送推理请求,还可以发送 abort 和 utility/control RPC 等。
- **Dummy steps for lockstep**:如果任意 DP replica 有工作,所有 replica 都会执行一个 forward step;没有请求的 replica 会执行一个 dummy step,以参与必要的同步点(避免阻塞活跃 replica)。
关于 lockstep 的澄清:它其实只对 MoE 模型是必需的,因为其中 expert layer 会形成 EP 或 TP group,而 attention layer 仍然是 DP。现在 DP 总是这么做,只是因为“内置”的非 MoE DP 用途有限;通常你完全可以运行多个独立 vLLM,再用普通方式在它们之间做负载均衡。
现在看第二部分:API server 节点上会发生什么?
## 在 API server 节点上
我们实例化一个 `AsyncLLM` 对象(围绕 LLM engine 的 asyncio wrapper)。它内部会创建一个 `DPLBAsyncMPClient`(data-parallel、load-balancing、asynchronous、multiprocessing client)。
在 `MPClient` 的 parent class 里,`launch_core_engines` 函数会运行并:
1. 创建启动 handshake 使用的 ZMQ 地址(和 headless 节点上看到的一样)。
2. 启动一个 `DPCoordinator` 进程。
3. 创建一个 `CoreEngineProcManager`(和 headless 节点上一样)。
在 `AsyncMPClient`(`MPClient` 的 child)里,我们会:
1. 创建一个 `outputs_queue`(`asyncio.Queue`)。
2. 创建一个 asyncio task `process_outputs_socket`,它会通过 output socket 和全部 4 个 `DPEngineCoreProc` 的 output thread 通信,并写入 `outputs_queue`。
3. 随后,另一个 asyncio task `output_handler`(来自 `AsyncLLM`)会从这个队列读取,最后把信息发给 `create_completion` 函数。
在 `DPAsyncMPClient` 里,我们会创建一个 asyncio task `run_engine_stats_update_task`,它负责和 DP coordinator 通信。
DP coordinator 在 frontend(API server)和 backend(engine core)之间做中介。它会:
- 定期向 frontend 的 `run_engine_stats_update_task` 发送负载均衡信息(queue size、waiting/running request)。
- 处理来自 frontend 的 `SCALE_ELASTIC_EP` 命令,动态改变 engine 数量(只适用于 Ray backend)。
- 向 backend 发送 `START_DP_WAVE` 事件(由 frontend 触发时),并回报 wave-state 更新。
回顾一下,frontend(`AsyncLLM`)会运行几个 asyncio task(记住:这是 concurrent,不是 parallel):
- 一类 task 通过 `generate` 路径处理输入请求(每个新的 client request 都会启动一个新的 asyncio task)。
- 两个 task(`process_outputs_socket`、`output_handler`)处理来自底层 engine 的输出消息。
- 一个 task(`run_engine_stats_update_task`)维持和 DP coordinator 的通信:发送 wave trigger、轮询 LB state,并处理动态扩缩容请求。
最后,主 server process 会创建一个 FastAPI app,并挂载 `OpenAIServingCompletion`、`OpenAIServingChat` 等 endpoint,暴露 `/completion`、`/chat/completion` 等接口。整个 stack 再通过 Uvicorn 提供服务。
所以,把这些放在一起,就是完整的请求生命周期!
你从终端发送:
```
curl -X POST http://localhost:8000/v1/completions -H "Content-Type: application/json" -d '{
"model": "TinyLlama/TinyLlama-1.1B-Chat-v1.0",
"prompt": "The capital of France is",
"max_tokens": 50,
"temperature": 0.7
}'
```
接下来会发生:
1. 请求命中 API server 上 `OpenAIServingCompletion` 的 `create_completion` route。
2. 这个函数异步 tokenize prompt,并准备 metadata(request ID、sampling params、timestamp 等)。
3. 然后它调用 `AsyncLLM.generate`,后者遵循和同步 engine 相同的流程,最终调用 `DPAsyncMPClient.add_request_async`。
4. 接着调用 `get_core_engine_for_request`,它会根据 DP coordinator 的状态在 engine 之间做负载均衡(选择 score 最小 / 负载最低的那个:`score = len(waiting) * 4 + len(running)`)。
5. `ADD` 请求被发送到被选中 engine 的 `input_socket`。
6. 在那个 engine 上:
- Input thread:解除阻塞,从 input socket 解码数据,并把一个 work item 放到 main thread 的 `input_queue` 上。
- Main thread:在 `input_queue` 上解除阻塞,把请求加入 engine,并反复调用 `engine_core.step()`,把中间结果 enqueue 到 `output_queue`,直到满足停止条件。
提醒一下:`step()` 会调用 scheduler、model executor(而它又可能是 `MultiProcExecutor`!)等。我们已经看过这些了!
- Output thread:在 `output_queue` 上解除阻塞,并通过 output socket 把结果发回。
7. 这些结果会触发 `AsyncLLM` 的输出 asyncio task(`process_outputs_socket` 和 `output_handler`),它们会把 token 传回 FastAPI 的 `create_completion` route。
8. FastAPI 附上 metadata(finish reason、logprobs、usage info 等),并通过 Uvicorn 向你的终端返回一个 `JSONResponse`!
就这样,你的 completion 回来了:整套分布式机械都藏在一个简单的 `curl` 命令后面!:) 太有意思了!!!
📝补充说明:
- 增加更多 API server 时,负载均衡由 OS / socket 层处理。从应用视角看,没有什么重要变化,复杂性被隐藏起来了。
- 使用 Ray 作为 DP backend 时,你可以暴露一个 URL endpoint(`/scale_elastic_ep`),用来自动上下扩缩 engine replica 的数量。
## Benchmark 和自动调参:延迟 vs 吞吐
到目前为止,我们一直在分析“气体粒子”:请求如何在 engine / 系统内部流动。现在该拉远视角,把系统作为一个整体来看,并问:我们如何衡量一个推理系统的性能?
最高层面有两个互相竞争的指标:
1. **延迟**:从请求提交到 token 返回所需的时间
2. **吞吐**:系统每秒可以生成 / 处理的 token 或请求数量
**延迟** 对交互式应用最重要,因为用户正在等待响应。
**吞吐** 对离线工作负载很重要,比如用于 pre/post-training 的合成数据生成、数据清洗 / 处理,以及一般来说任何离线批量推理任务。
在解释为什么延迟和吞吐互相竞争之前,先定义几个常见推理指标:
| 指标 | 定义 |
| --- | --- |
| `TTFT` (time to first token) | 从请求提交到收到第一个输出 token 的时间 |
| `ITL` (inter-token latency) | 两个连续 token 之间的时间(例如从 token i-1 到 token i) |
| `TPOT` (time per output token) | 一个请求中所有输出 token 的平均 ITL |
| `Latency / E2E` (end-to-end latency) | 处理一个请求的总时间,也就是 TTFT + 所有 ITL 之和;等价于从提交请求到收到最后一个输出 token 的时间 |
| `Throughput` | 每秒处理的总 token 数(输入、输出或两者),也可以是每秒请求数 |
| `Goodput` | 满足服务级目标(SLO)的吞吐,例如 max TTFT、TPOT 或 e2e latency。举例来说,只有满足这些 SLO 的请求中的 token 才会被计入 |
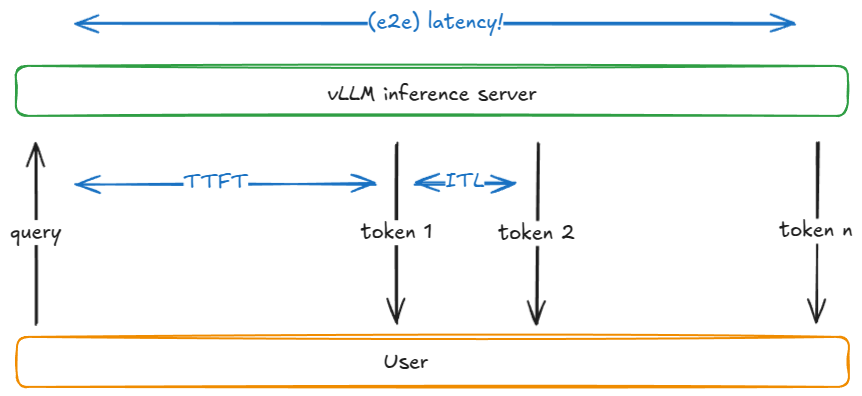
ttft、itl、e2e latency
下面是一个简化模型,用来解释这两个指标为什么互相竞争。
假设:主要瓶颈是 weight i/o,而不是 KV cache i/o;也就是说,我们处理的是短序列。
看 batch size `B` 如何影响单个 decode step,这个权衡就很清楚了。当 `B ↓` 接近 1 时,ITL 会下降:每一步的工作更少,这个 token 不再和其他 token“竞争”。当 `B ↑` 趋向无穷大时,ITL 会上升,因为每一步做的 FLOPs 更多;但吞吐会提高(直到达到峰值性能),因为 weight I/O 被更多 token 摊薄了。
roofline model 有助于理解这里的情况:在 saturation batch `B_sat` 以下,step time 由 HBM bandwidth 主导(逐层把权重流式读入 on-chip memory),所以 step latency 几乎是平的:计算 1 个和 10 个 token 可能用差不多的时间。超过 `B_sat` 之后,kernel 变成 compute-bound,step time 大致随 `B` 增长;每增加一个 token 都会增加 ITL。
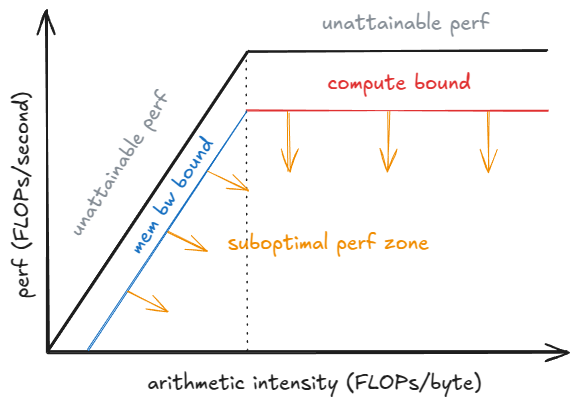
roofline perf model
📝说明:
更严谨地说,我们还必须考虑 kernel auto-tuning:随着 `B` 增长,runtime 可能会为这个 shape 切换到更高效的 kernel,从而改变实际达到的性能 `P_kernel`。Step latency 是 `t = FLOPs_step / P_kernel`,其中 `FLOPs_step` 是这一步的工作量。可以看到,当 `P_kernel` 达到 `P_peak` 之后,每一步更多的计算会直接带来延迟上升。
## 如何在 vLLM 中做 benchmark
vLLM 提供了一个 `vllm bench {serve,latency,throughput}` CLI,它封装了 vllm / benchmarks / {server,latency,throughput}.py。
这些脚本做的事情如下:
- **latency**:使用短输入(默认 32 个 token),用小 batch(默认 8)采样 128 个输出 token。它会运行多次迭代,并报告这个 batch 的 e2e latency。
- **throughput**:一次性提交一组固定 prompt(默认:1000 个 ShareGPT sample,也就是 `QPS=Inf` 模式),并报告整个运行期间的输入 / 输出 / 总 token 每秒数量和请求每秒数量。
- **serve**:启动一个 vLLM server,并通过从 Poisson(或更一般的 Gamma)分布中采样请求到达间隔,模拟真实世界工作负载。它会在一个时间窗口内发送请求,测量我们讨论过的所有指标,也可以选择强制 server 端最大并发(通过 semaphore,例如把 server 限制为 64 个并发请求)。
下面是运行 latency 脚本的一个例子:
```
vllm bench latency
--model <model-name>
--input-tokens 32
--output-tokens 128
--batch-size 8
```
CI 中使用的 benchmark 配置位于 `.buildkite/nightly-benchmarks/tests`。
还有一个 auto-tune 脚本会驱动 serve benchmark,寻找满足目标 SLO 的参数设置(例如“在保持 p99 e2e < 500 ms 的同时最大化吞吐”),并返回一个建议配置。
## 结语
我们从基本的 engine core(`UniprocExecutor`)开始,加入 speculative decoding 和 prefix caching 等高级特性,纵向扩展到 `MultiProcExecutor`(带 `TP/PP > 1`),最后横向扩展,把所有东西包进异步 engine 和分布式服务 stack,并以如何衡量系统性能收尾。
vLLM 还包含一些我跳过的专门处理。例如:
- **多样化硬件 backend:** TPU、AWS Neuron(Trainium/Inferentia)等
- **架构 / 技术:** `MLA`、`MoE`、encoder-decoder(例如 Whisper)、pooling/embedding 模型、`EPLB`、`m-RoPE`、`LoRA`、`ALiBi`、attention-free 变体、sliding-window attention、多模态 LM,以及 state-space model(例如 Mamba/Mamba-2、Jamba)
- **TP/PP/SP**
- **Hybrid KV-cache logic**(Jenga)、beam sampling 等更复杂的采样方法,以及更多内容
- **Experimental**:async scheduling
好的一点是,这些内容大多和上面描述的主流程正交:你几乎可以把它们看作“plugin”(当然,实践中会有一些耦合)。
我喜欢理解系统。话虽如此,在这个高度上,分辨率确实会受影响。在下一篇文章里,我会放大到具体子系统,进入更细的实现细节。
💡联系我:
如果你发现文章里有任何错误,请 DM 我;欢迎通过 [X](https://x.com/gordic_aleksa)、[LinkedIn](https://www.linkedin.com/in/aleksagordic/) 或 [匿名反馈](https://docs.google.com/forms/d/1z1fEirrN2xtGxAsJvptpM7yV4ByT5SF25S-XiMPrXNA/edit) 给我留言。
## 致谢
非常感谢 [Hyperstack](https://www.hyperstack.cloud/) 在过去一年里为我的实验提供 H100!
感谢 [Nick Hill](https://www.linkedin.com/in/nickhillprofile/)(vLLM 核心贡献者,RedHat)、[Mark Saroufim](https://x.com/marksaroufim)(PyTorch)、[Kyle Krannen](https://www.linkedin.com/in/kyle-kranen/)(NVIDIA,Dynamo)和 [Ashish Vaswani](https://www.linkedin.com/in/ashish-vaswani-99892181/) 阅读本文发布前的版本并提供反馈!
## 参考资料
1. vLLM <https://github.com/vllm-project/vllm>
2. "Attention Is All You Need", <https://arxiv.org/abs/1706.03762>
3. "Efficient Memory Management for Large Language Model Serving with PagedAttention", <https://arxiv.org/abs/2309.06180>
4. "DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model", <https://arxiv.org/abs/2405.04434>
5. "Jenga: Effective Memory Management for Serving LLM with Heterogeneity", <https://arxiv.org/abs/2503.18292>
6. "Orca: A Distributed Serving System for Transformer-Based Generative Models", <https://www.usenix.org/conference/osdi22/presentation/yu>
7. "XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models", <https://arxiv.org/abs/2411.15100>
8. "Accelerating Large Language Model Decoding with Speculative Sampling", <https://arxiv.org/abs/2302.01318>
9. "EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty", <https://arxiv.org/abs/2401.15077>
10. "Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads", <https://arxiv.org/abs/2401.10774>
11. LMCache, <https://github.com/LMCache/LMCache>