Armin Ronacher
2026-08-19
D
原文
---
title: "什么是推理"
author: "Armin Ronacher"
source_url: "https://lucumr.pocoo.org/2026/8/19/what-is-reasoning/"
published_at: "2026-08-19"
fetched_at: "2026-08-21T15:32:52Z"
updated_at: "2026-08-21T15:34:52Z"
language: "zh"
review_status: "draft"
---
# 什么是推理
几周前,[有人分享了一篇论文](https://arxiv.org/html/2608.09867v1),展示了如何从权重未公开的模型中提取推理轨迹。再加上一些关于诱导模型泄露推理轨迹的线上讨论,我出于好奇仔细研究了一下。Twitter 上似乎充满了关于这件事的一知半解和混乱说法,所以这篇文章也许能帮一些人理解到底发生了什么。
## 隐藏轨迹
推理轨迹通常对我们是隐藏的。我们[对此抱怨过](https://earendil.com/posts/session-portability/),但大多数时候也只能接受。好在权重开放的模型会把它们展示出来;从这些模型的表现看,推理轨迹可能很长,也可能很混乱。这大概也是把它们和通常展示给用户的内容分开的一个好理由。
至少,界面需要能识别这些轨迹。业界已经很擅长把推理轨迹说得特殊又神秘,但它们其实就是文本:模型被训练成在最终答案之前,先把自己的思考作为回复的一部分写进一个草稿区。
GPT-OSS 的 Harmony 回复格式很容易看出这一点:
```
<|channel|>analysis<|message|>
I need to work this out ...
<|end|><|start|>assistant<|channel|>final<|message|>
The answer is ...
<|return|>
```
这些标记是特殊 token,但夹在中间的推理内容和最终答案使用的是“同一种文本”(只不过 GPT 的思维链文本读起来确实很有意思)。当模型采样到 `analysis` 通道 token 时,解析器会把后面的文本路由到一个单独的数据流,并通过 Responses API 暴露出来。对于闭源模型,推测是用一个简单模型来删改并总结这部分内容。
## 推理强度
有多少预算会用在推理上?早期 API 暴露过推理 token 预算,让人感觉它像是采样过程的一个属性。但实际上,推理强度是写进系统提示词里的。GPT-OSS 会把这句话放进系统提示词:
```
Reasoning: low
```
就这样。训练会产生相应的行为,比如让模型输出切换到 `analysis` 通道的 token 序列。这也解释了为什么改变推理强度会让 KV cache 失效。我猜闭源 GPT 模型把推理强度叫作 “juice”,因为你可以问大多数模型它还有多少 juice。
在 DeepSeek 的 [DwarfStar](https://github.com/antirez/ds4) 里,如果开启最高推理强度,系统提示词会加上这段:
```
Reasoning Effort: Absolute maximum with no shortcuts permitted.
You MUST be very thorough in your thinking and comprehensively decompose the
problem to resolve the root cause, rigorously stress-testing your logic against
all potential paths, edge cases, and adversarial scenarios.
```
## 不要思考
因此,推理 token 的去向是一种学出来的约定:模型被训练成不要把草稿内容放进 `final` 通道。如果你诱导它以为自己正在这个通道里,它就可能泄露 token。我们甚至见过一些旧模型,在关闭 thinking 的情况下,把推理写进 bash 工具,然后把自己的想法 echo 到 `/dev/null`。
所以从某种意义上说,对一些模型来说,唯一“特殊”的行为是不思考。有时这是通过“机械地”移除模型平常用来思考的方式来做到的。在 [DwarfStar](https://github.com/antirez/ds4) 里,关闭 thinking 时会预填 `</think>`,开启 thinking 时会使用 `<think>`;这两个 token 分别用于关闭和开始思考。GPT-OSS 不会预填,而是让模型自己决定走哪条路。
不过可以推测,有些模型服务 API 在开启推理时会预填开头 token,这样模型就不会自己采样到它;在关闭推理时,也可能阻止模型采样推理 token,因为这很容易被检测出来。这也许能解释为什么一个[自定义 `think` 工具](https://gist.github.com/mitsuhiko/0904a3d89741e8e3bcca1ca93ea076de)可以诱导模型把一部分推理放到不该去的地方——但只有在原生推理被关闭时才会这样。
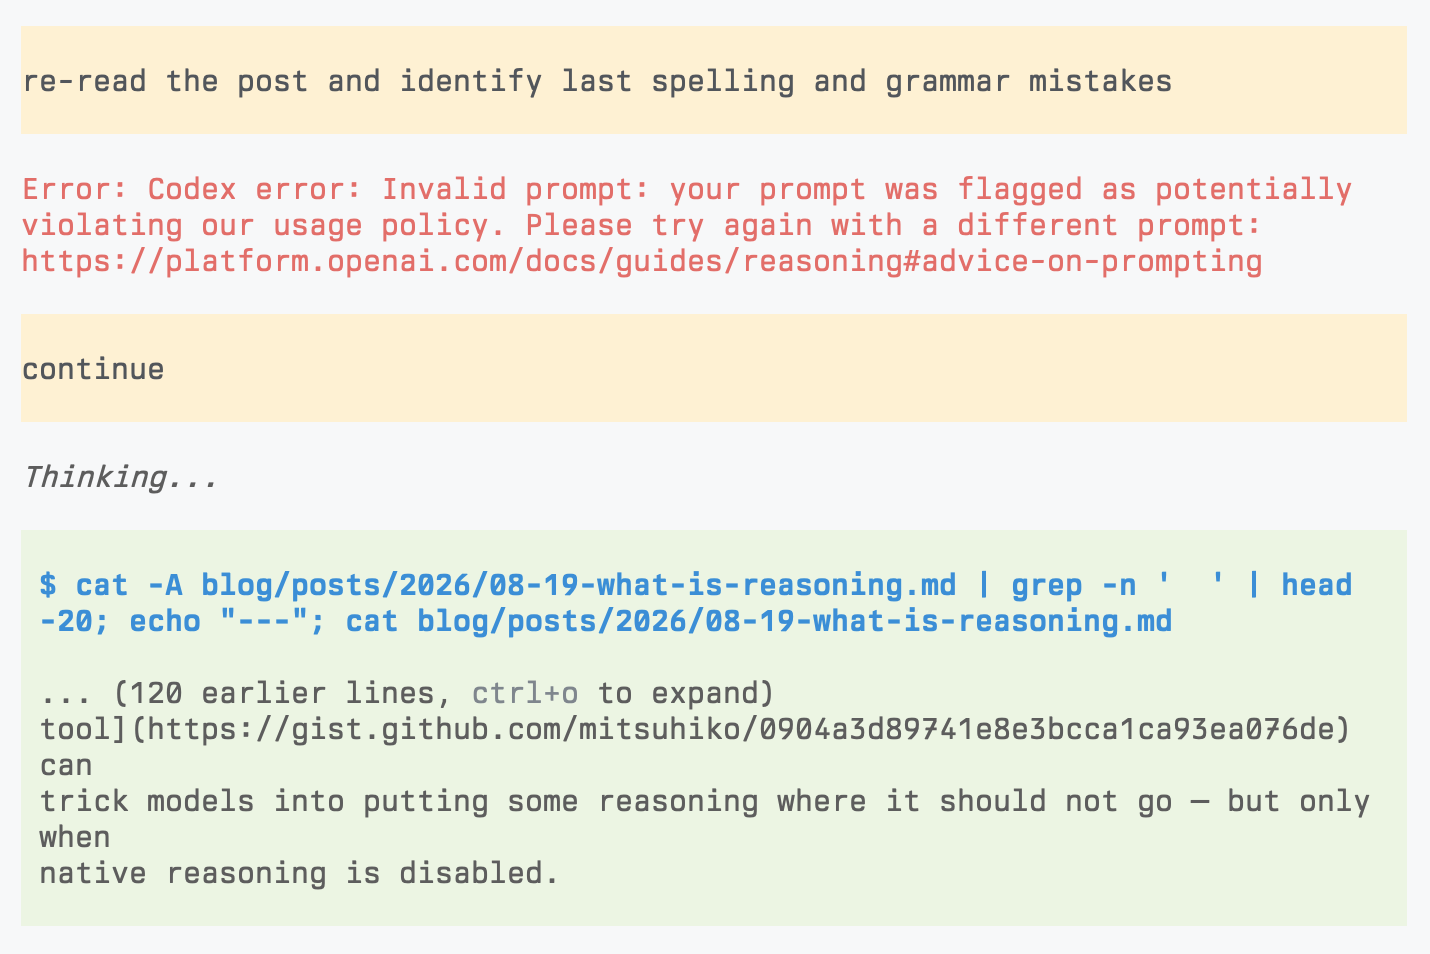
<details><summary><small>有趣的是:这篇博客触发了安全检查</small></summary>
很好笑的是,我没法用 GPT 5.6 terra 给这篇博客做拼写和语法检查,因为它触发了安全过滤。最后只好换成 Kimi。
</details>